本文最后更新于0 天前,其中的信息可能已经过时,如有错误请发送邮件到big_fw@foxmail.com
一、CNN 到底解决什么问题
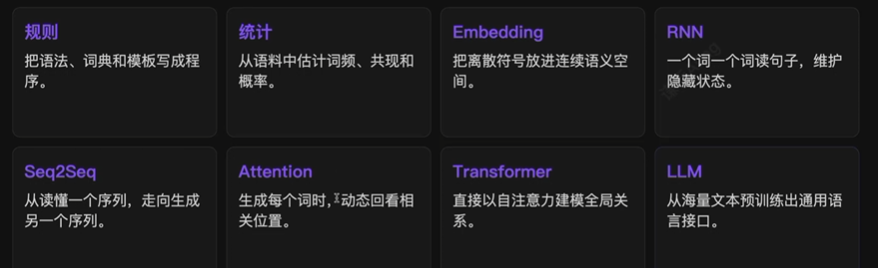
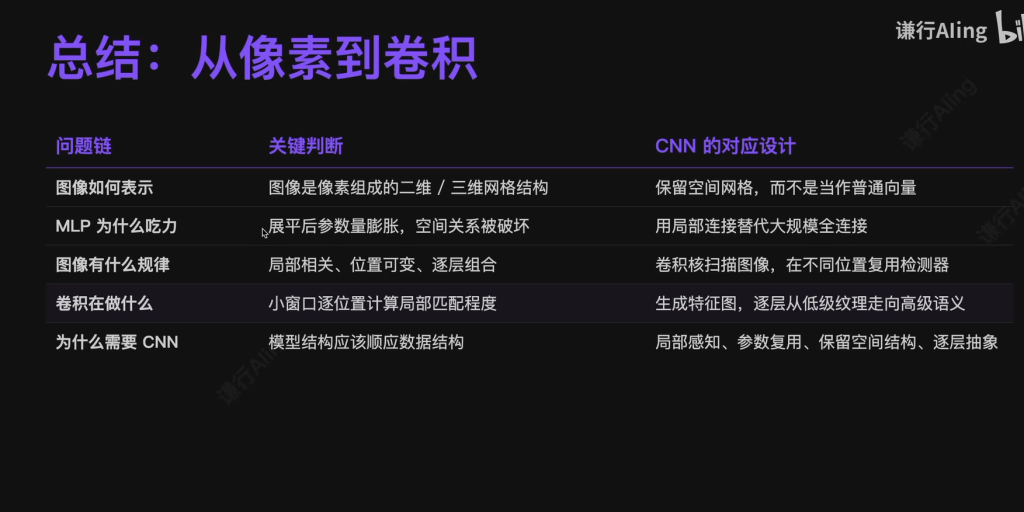
传统全连接网络处理图像有三个致命问题:
| 问题 | 说明 | CNN 的解法 |
|---|---|---|
| 参数量爆炸 | 一张 224×224×3 的图,接 1000 个隐层神经元就是 1.5 亿参数 | 局部连接 |
| 丢失空间结构 | 把图像展平成一维向量,邻域关系被破坏 | 保留 2D 特征图,卷积核在空间上滑动 |
| 平移不敏感 | 猫往左挪 10 像素,网络就当新样本重学一遍 | 权值共享 + 池化 → 平移等变性/不变性 |
三条核心:
- 局部性:相邻像素高度相关,远处的可先不关心。
- 平移等变性:同一特征出现在任何位置,都用同一个卷积核去检测。
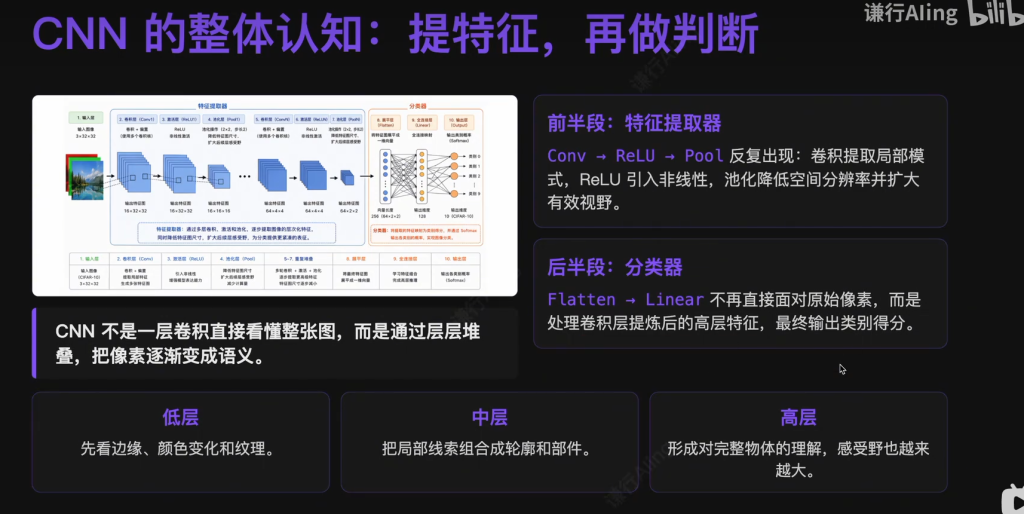
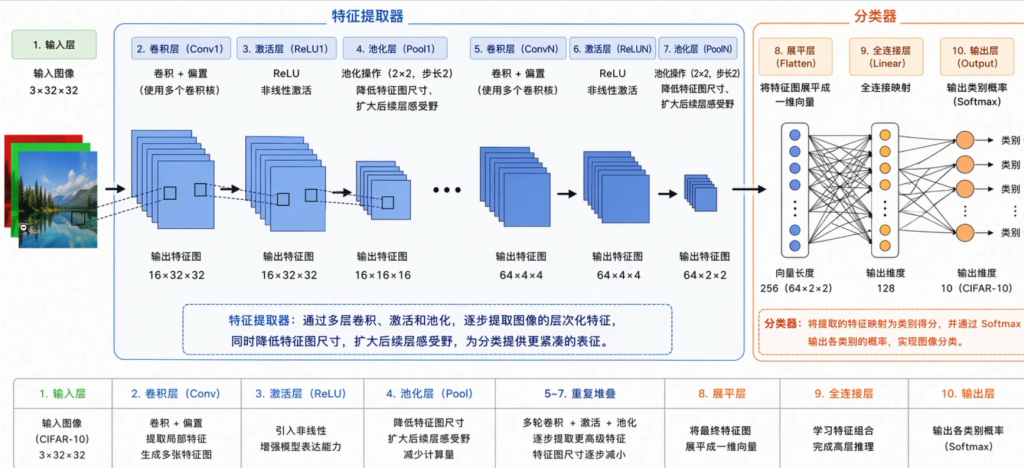
- 层次性:浅层学边缘/纹理,中层学部件,深层学整体语义
二.核心架构
三、核心组件
3.1 卷积层
四个关键超参数
| 参数 | 符号 | 作用 |
|---|---|---|
| 卷积核大小 | K(kernel size) | 感受野的边长,常用 1/3/5/7 |
| 步长 | S(stride) | 滑动跨度,S>1 即下采样 |
| 填充 | P(padding) | 边缘补 0,控制输出尺寸、保护边缘信息 |
| 输出通道数 | C_out | 即卷积核个数,每个核学一种模式 |
输出尺寸公式
H_out = floor( (H_in + 2P - K) / S ) + 1
W_out = floor( (W_in + 2P - K) / S ) + 1
空洞卷积
H_out = floor( (H_in + 2P - d*(K-1) - 1) / S ) + 1
d 为膨胀率。不增加参数即可扩大感受野,代价是采样稀疏,常用于语义分割和实时检测。
参数量与计算量(单个卷积层)
参数量  Params = (K × K × C_in + 1) × C_out
计算量  FLOPs ≈ 2 × H_out × W_out × C_out × K × K × C_in
注意:卷积层的参数量与输入图像尺寸无关,只与 K、C_in、C_out 有关。这是 CNN 相对 FC 的最大优势。
几种重要的卷积变体
| 变体 | 核心思想 | 典型用途 |
|---|---|---|
| 1×1 卷积 | 只在通道维做线性组合,跨通道信息融合 | 升降维、瓶颈结构、加非线性 |
| 分组卷积 | 通道分成 g 组,组内独立卷积,参数降为 1/g | AlexNet(双 GPU)、ResNeXt |
| 深度可分离卷积 | Depthwise(K×K) + Pointwise(1×1),参数量降为约 1/K² | MobileNet、Xception |
| 转置卷积 | 反向的卷积(上采样),通过学习得到而非插值 | 分割、超分、GAN 生成器 |
| 可变形卷积 | 采样点位置可学习偏移 | 目标检测(DCN) |
3.2 激活函数
| 函数 | 公式 | 特点 |
|---|---|---|
| Sigmoid | 1/(1+e⁻ˣ) | 易梯度消失、输出非零均值,几乎不用 |
| Tanh | (eˣ-e⁻ˣ)/(eˣ+e⁻ˣ) | 零均值,仍会梯度消失 |
| ReLU | max(0, x) | 计算极快、缓解梯度消失;有”死亡 ReLU”问题 |
| LeakyReLU | max(αx, x) | α 常取 0.01,修复死亡神经元 |
| GELU | x·Φ(x) | 平滑,Transformer/ConvNeXt 主流 |
| SiLU/Swish | x·sigmoid(x) | MobileNetV3、EfficientNet 常用 |
3.3 池化层
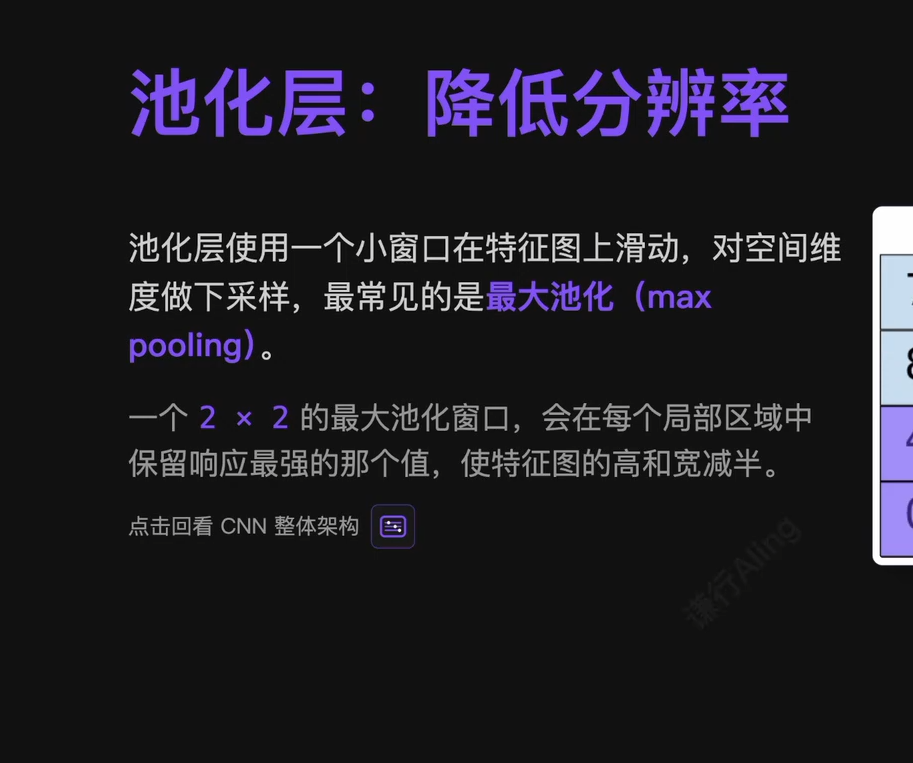
| 类型 | 做法 | 特点 |
|---|---|---|
| 最大池化 | 取窗口内最大值 | 保留最强响应,最常用 |
| 平均池化 | 取窗口内均值 | 更平滑,早期网络用 |
| 全局平均池化 GAP | 对每个通道整图取均值 | 直接替代 FC 层,参数量为 0,抗过拟合 |
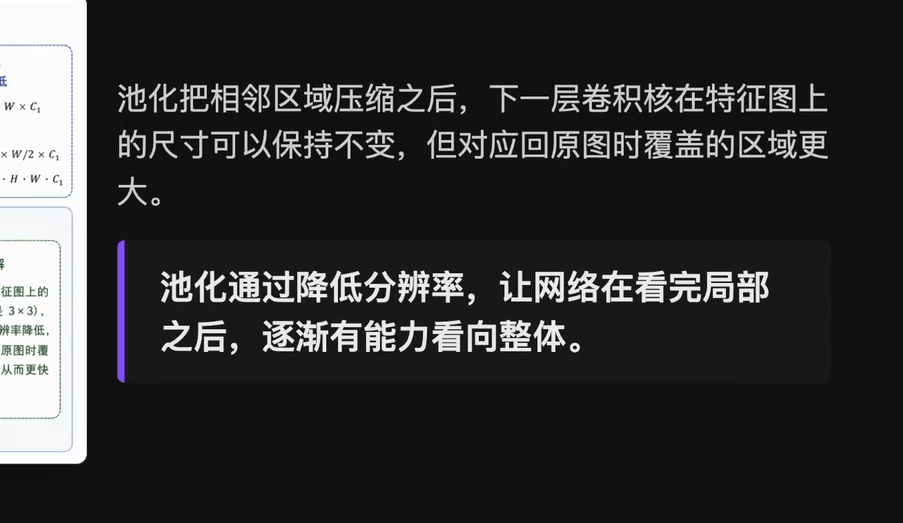
池化无可学习参数,作用是降低分辨率、扩大感受野、提供一定平移不变性。
3.4 归一化层
| 类型 | 归一化维度 | 适用场景 |
|---|---|---|
| BN(Batch Norm) | 对 (N, H, W) 求统计量 | CNN 默认选择;小 batch 时效果差 |
| LN(Layer Norm) | 对 (C, H, W) 求统计量 | Transformer、RNN、小 batch |
| IN(Instance Norm) | 对 (H, W) 求统计量,每样本每通道独立 | 风格迁移 |
| GN(Group Norm) | 通道分组后归一化 | 检测/分割小 batch 场景 |
BN 的作用:缓解内部协变量偏移、允许更大学习率、加速收敛、有轻微正则效果。
3.5 Dropout 与正则化
- Dropout:训练时随机置零部分神经元(p 常 0.5,CNN 中用 0.1~0.3),推理时全部使用并按比例缩放。等价于集成多个子网络。现多用在 FC 层。
- DropBlock:CNN 专用,随机丢弃连续区域而非单点,因为相邻像素信息冗余。
- 权重衰减 L2、标签平滑、数据增强也是标配。
四、感受野
定义:输出特征图上一个像素,对应到原始输入图像上的区域大小。
递推公式:
RF_l = RF_{l-1} + (K_l - 1) × ∏_{i=1}^{l-1} S_i
- 初始
RF_0 = 1 S_i是第 i 层的步长,∏ S_i是到第 l-1 层的累计下采样倍数(stride product)
如果你知道当前层的感受野,想推前一层的感受野:
RF(前) = (RF(后) – 1) × S(前) + K(前)
关键结论
- 堆叠小卷积核 > 用一个大卷积核:两个 3×3 的感受野等于一个 5×5,但参数从 25 降到 18,且多了两次非线性。
- 感受野可以比输入图像还大(说明覆盖了全图)。
- 有些像素的有效感受野远小于理论值,呈高斯分布,中心权重高。
五、残差连接
ResNet 残差块核心
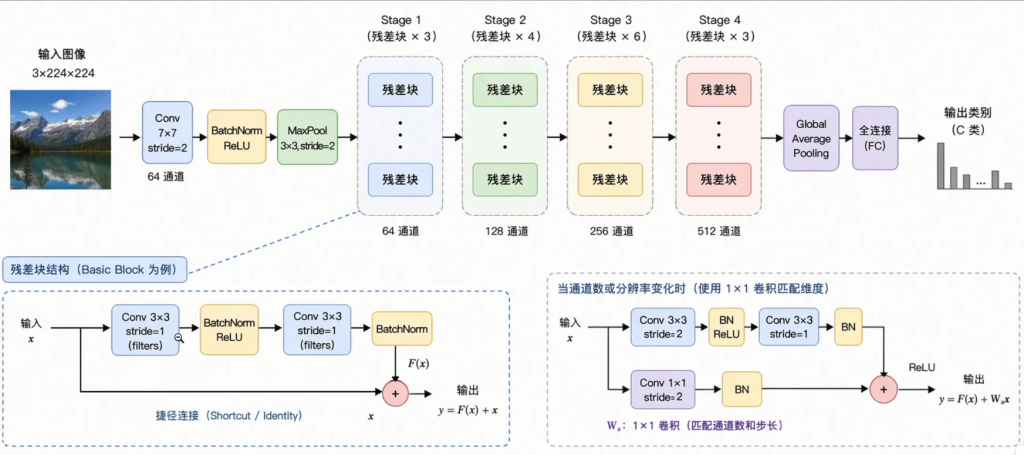
输出 = F(x) + x (恒等映射捷径)
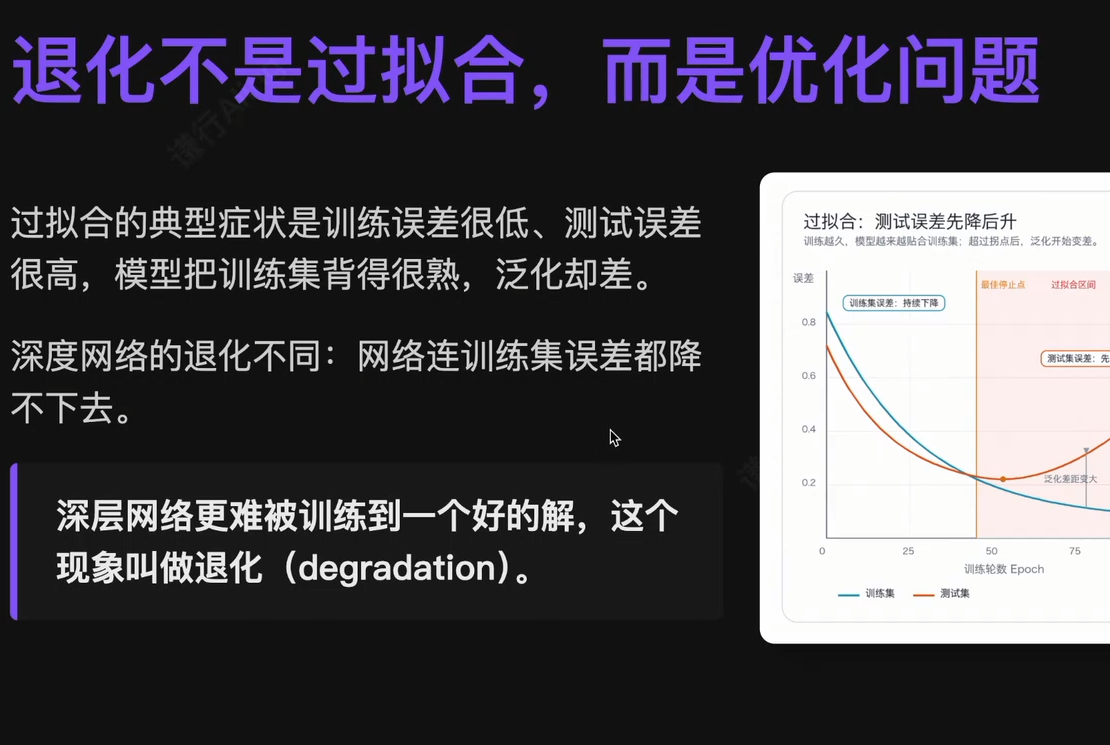
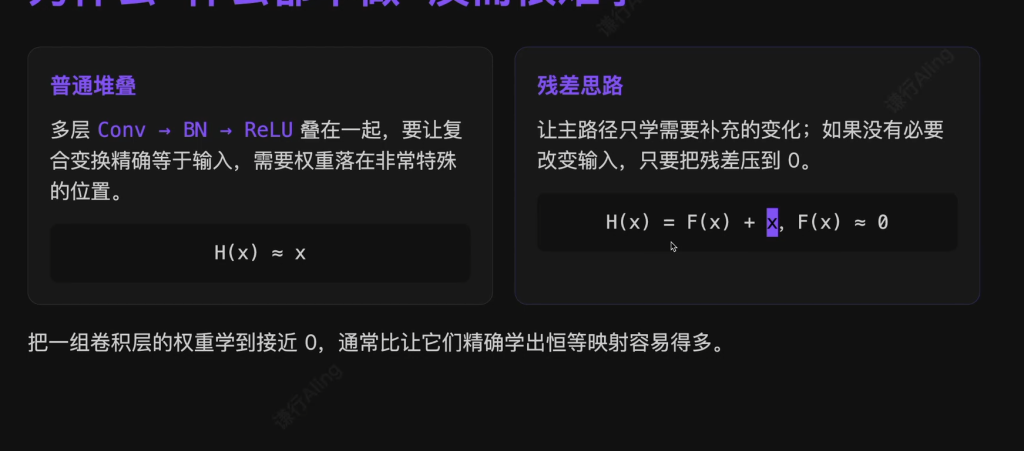
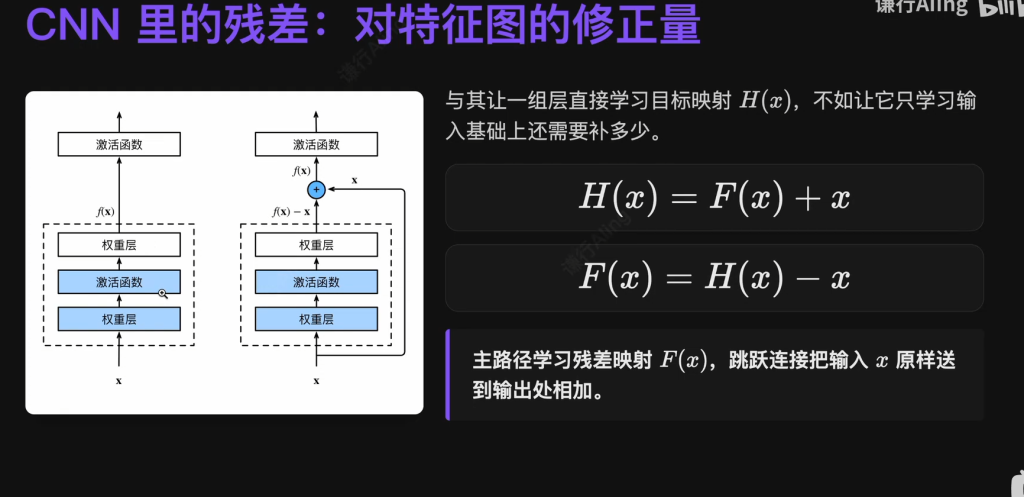
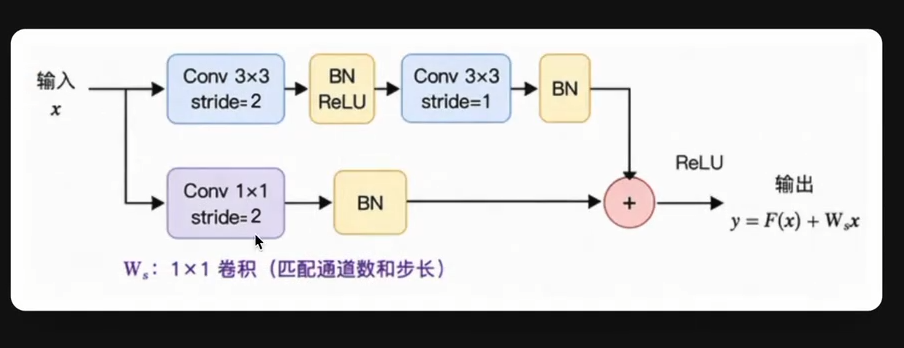
为什么有效:反向传播时梯度可经捷径无损回传,缓解梯度消失在深层网络的累积衰减;同时把学习目标从”学完整映射 H(x)”转变为”学残差 F(x)=H(x)-x”,任务更简单。
六、训练与调优要点
初始化
- 不能全零(对称性无法打破)
- Xavier/Glorot:适合 tanh/sigmoid,
Var = 2/(fan_in + fan_out) - He/Kaiming:配合 ReLU,
Var = 2/fan_in,CNN 默认
优化器
- SGD + Momentum:泛化常更好,CNN 视觉任务经典选择
- Adam / AdamW:收敛快,小数据集/Transformer 友好;AdamW 修正了权重衰减的实现
学习率调度
- Warmup + Cosine Annealing / Step Decay / OneCycle
- 大 batch 要相应放大学习率(线性缩放规则)
数据增强
- 基础:随机裁剪、水平翻转、色彩抖动
- 进阶:Mixup、CutMix、RandAugment、AutoAugment
- 注意:水平翻转对数字/文字识别等有语义的场景可能有害
迁移学习
- 冻结主干只训分类头(小数据)→ 逐步解冻微调 → 全网络微调 + 小学习率
七、PyTorch 最小实现模板
import torch
import torch.nn as nn
class SmallCNN(nn.Module):
def __init__(self, num_classes=10):
super().__init__()
self.features = nn.Sequential(
nn.Conv2d(3, 32, kernel_size=3, padding=1, bias=False),
nn.BatchNorm2d(32),
nn.ReLU(inplace=True),
nn.MaxPool2d(2), # 224 -> 112
nn.Conv2d(32, 64, kernel_size=3, padding=1, bias=False),
nn.BatchNorm2d(64),
nn.ReLU(inplace=True),
nn.MaxPool2d(2), # 112 -> 56
nn.Conv2d(64, 128, kernel_size=3, padding=1, bias=False),
nn.BatchNorm2d(128),
nn.ReLU(inplace=True),
)
self.pool = nn.AdaptiveAvgPool2d(1) # 全局平均池化
self.classifier = nn.Sequential(
nn.Flatten(),
nn.Dropout(0.2),
nn.Linear(128, num_classes),
)
def forward(self, x):
x = self.features(x)
x = self.pool(x)
return self.classifier(x)
if __name__ == "__main__":
model = SmallCNN()
x = torch.randn(8, 3, 224, 224)
print(model(x).shape) # torch.Size([8, 10])
total = sum(p.numel() for p in model.parameters())
print(f"参数量: {total/1e6:.3f}M")