一.常见ai模型格式
1. GGUF
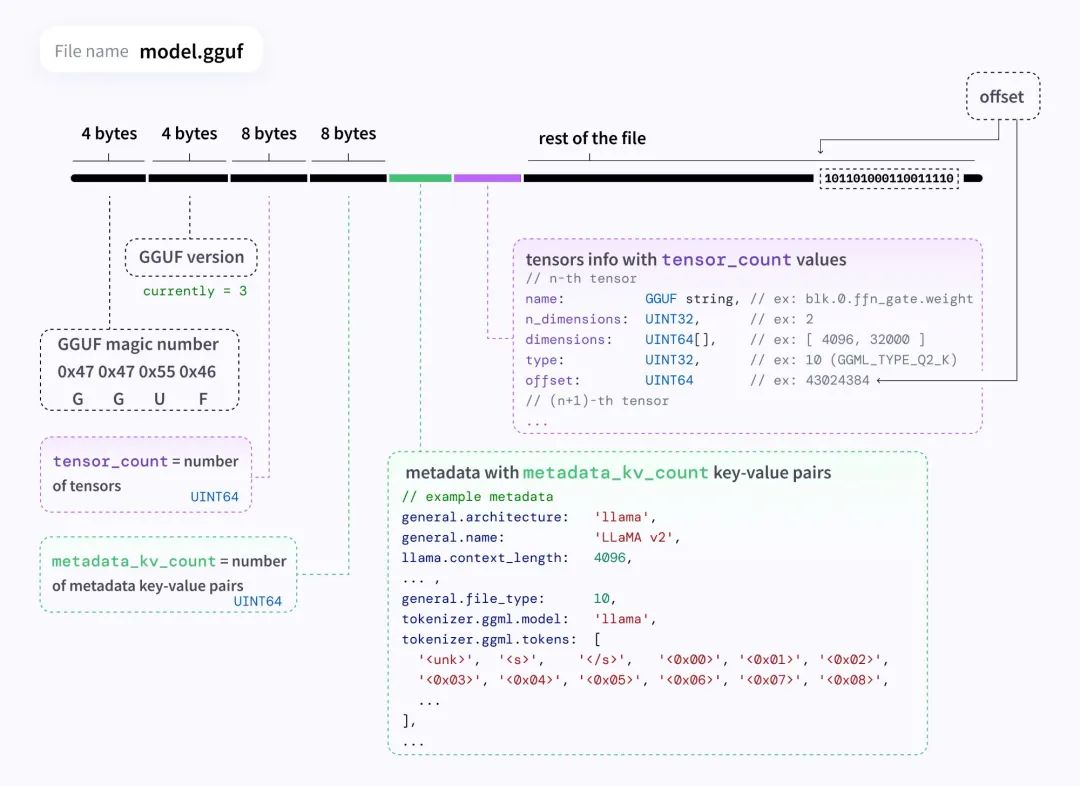
最初为 llama.cpp 项目开发,是一种二进制格式,目标是快速加载/保存且易于读取。模型通常先用 PyTorch 等框架开发,再转成 GGUF 配合 GGML 使用。
如今 GGUF 已成开源社区最流行的模型分享格式之一,被主流推理运行时支持:
主要面向语言模型;其他类型(如扩散模型)可通过 stable-diffusion.cpp 使用,但不如 LLM 普及。
文件结构
- 元数据段:键值对组织,含架构、版本、超参数
- 张量元数据段:张量的形状、数据类型、名称
- 张量数据段:张量本体
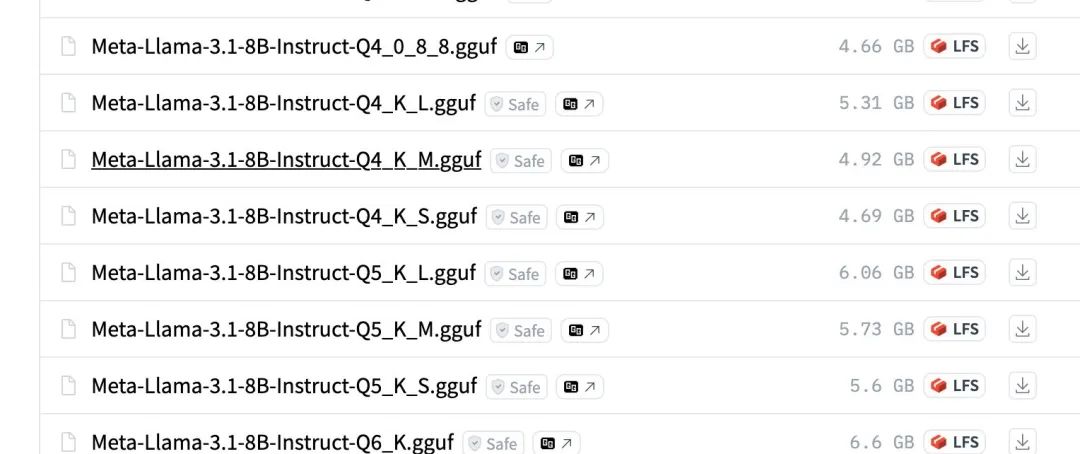
| 方案 | 说明 | 特点 |
|---|---|---|
Q4_K_M | 多数张量 4bit,部分 6bit | 最常用,精度与体积平衡 |
IQ4_XS | 几乎所有张量 4bit + 重要性矩阵校准 | 保持存储效率的同时提升精度 |
IQ2_M | 类似 IQ4_XS 但为 2bit | 最激进,极低内存硬件可用 |
Q8_0 | 全部张量 8bit | 最不激进,精度接近原模型 |
优缺点
优点
- 简单:单文件,易分享分发
- 快速:兼容
mmap(),加载/保存快 - 高效:量化方案灵活
- 便携:二进制格式,无需特定库即可读
缺点
- 多数模型需从 PyTorch / Safetensors 转换而来
- 并非所有模型都可转换(部分不被 llama.cpp 支持)
- 转成 GGUF 后不易修改或微调
适用场景
生产环境模型服务(加载速度关键)+ 开源社区模型共享。
2. PyTorch(.pt / .pth)
.pt / .pth 是 PyTorch 的默认序列化格式,存储包含学习参数(权重、偏置)、优化器状态和训练元数据的模型状态字典。
.pt:保存整个模型(架构 + 学习参数).pth:仅保存状态字典(学习参数 + 部分元数据)
底层基于 Python 的 pickle 模块做对象序列化。
import pickle
model_state_dict = {"layer1": "hello", "layer2": "world"}
pickle.dump(model_state_dict, open("model.pkl", "wb"))

# 读回
model_state_dict = pickle.load(open("model.pkl", "rb"))
print(model_state_dict)  # {'layer1': 'hello', 'layer2': 'world'}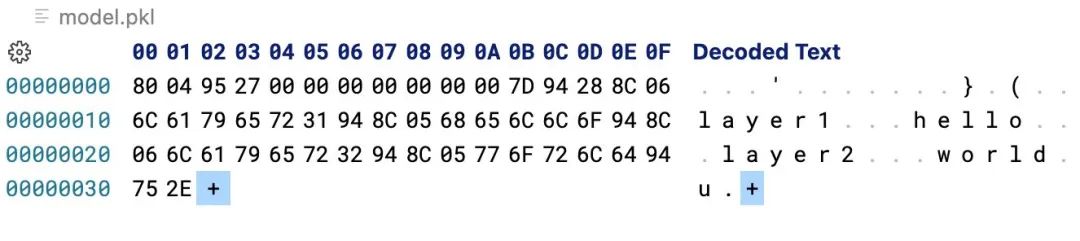
pickle 的三大局限
- 安全性:任何东西都能被 pickle,包括恶意代码。序列化数据未经验证即加载会造成安全漏洞。参见 Snyk:pickle 投毒与 .pth 文件后门
- 效率:不支持延迟加载 / 部分加载,大模型加载慢、内存占用高
- 可移植性:Python 专属,跨语言共享困难
结论
只在纯 Python + PyTorch 环境里工作时可用。近年社区已明显转向更高效安全的 GGUF 和 Safetensors。
3. Safetensors
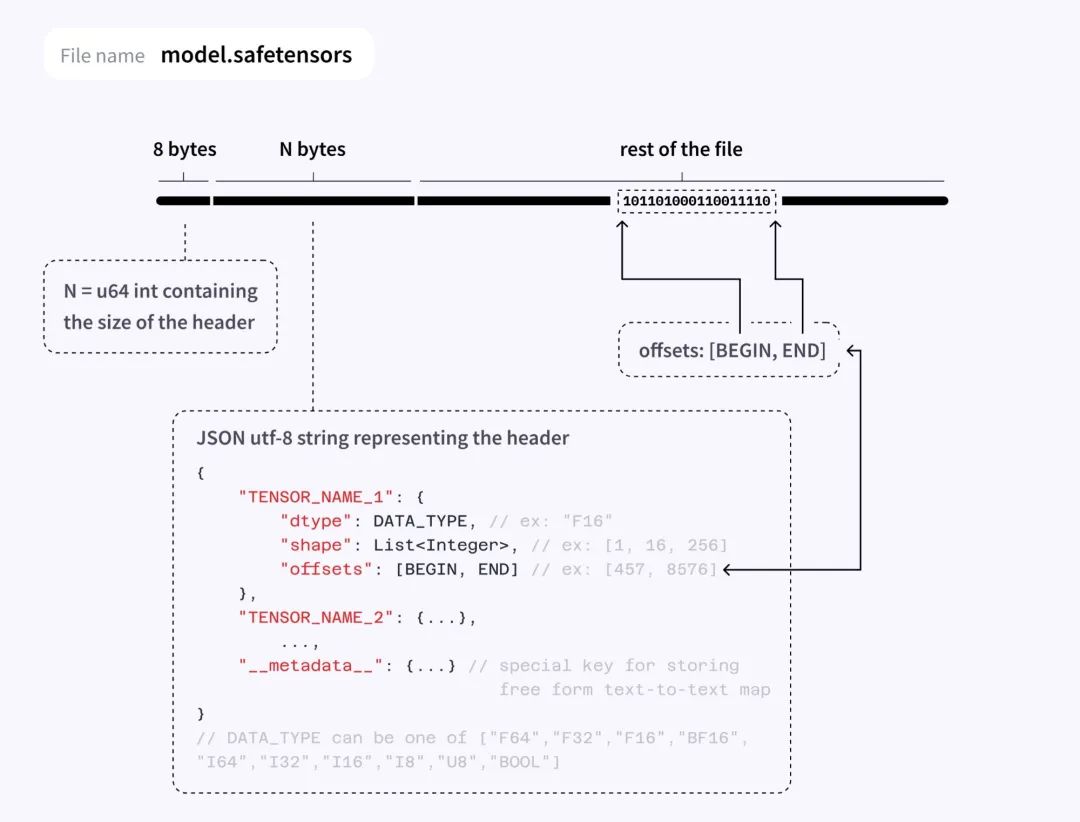
由 Hugging Face 开发,用于解决 pickle 的安全与效率问题。采用受限的反序列化过程防止代码执行漏洞。
文件结构
- 元数据段(JSON 格式):所有张量的形状、数据类型、名称,可选自定义元数据
- 张量数据段
优缺点
优点
- 安全:受限反序列化,防代码执行漏洞
- 快速:支持延迟加载与部分加载,可
mmap()映射文件 - 高效:支持量化张量
- 可移植:跨编程语言设计
缺点
- 量化方案不如 GGUF 灵活(主因是 PyTorch 量化支持有限)
- 读元数据需 JSON 解析器,在 C++ 等底层语言中较麻烦
地位
Safetensors 是 Hugging Face transformers 库的默认序列化格式,广泛用于模型的共享、训练、微调和部署。HF 上新发布的模型都以 safetensors 存储,包括 Llama、Gemma、Phi、Stable-Diffusion、Flux 等。
4. ONNX
Open Neural Network Exchange(开放神经网络交换格式),提供与供应商无关的模型表示方法,是 ONNX 生态 的一部分——包含 PyTorch、TensorFlow、MXNet 等框架间的互操作工具与库。
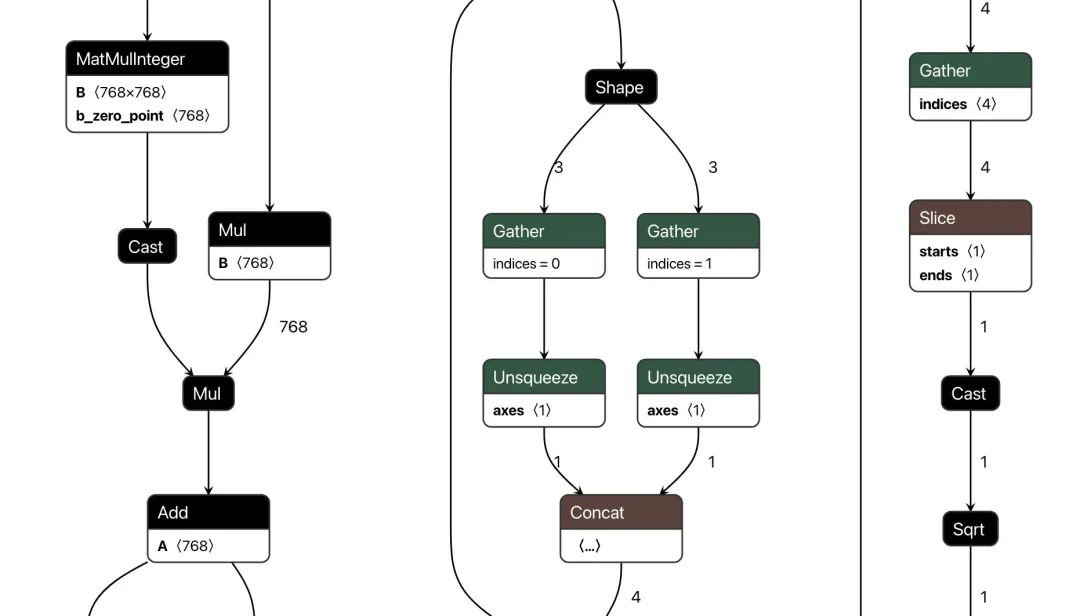
单文件 .onnx 保存。与 GGUF / Safetensors 的关键差异:ONNX 不仅包含张量和元数据,还包含模型的「计算图」。
文件里带计算图 = 处理模型时更灵活。例如新模型发布时可直接转为 ONNX,无需关心其架构或推理代码。
优缺点
优点
- 灵活性:文件内自带计算图,跨框架转换更灵活
- 可移植性:依托 ONNX 生态,可轻松部署到各类平台与设备,含移动端和边缘设备
缺点
- 对量化张量支持有限:ONNX 本身不支持量化张量,而是拆成整数张量 + 比例因子张量,处理量化模型时可能掉质量
- 复杂架构:不支持的层需要算子回退或自定义实现,转换时可能带来性能损失
结论
处理移动设备或浏览器内推理时,ONNX 是好选择。
5. HuggingFace 模型仓库的文件格式
5.1 一个典型 LLM 仓库的目录结构
Qwen/Qwen2.5-7B-Instruct/
├── .gitattributes                    # LFS 规则:哪些后缀走大文件存储
├── README.md                         # Model Card(YAML frontmatter + Markdown 正文)
├── config.json                       # 模型架构配置:决定 transformers 用哪个模型类
├── generation_config.json            # 生成参数默认值(温度、top_p、eos 等)
├── model-00001-of-00004.safetensors  # 权重分片(单文件时叫 model.safetensors)
├── model-00002-of-00004.safetensors
├── model-00003-of-00004.safetensors
├── model-00004-of-00004.safetensors
├── model.safetensors.index.json      # 分片索引:参数名 → 分片文件
├── tokenizer.json                    # 完整 tokenizer(快,推荐)
├── tokenizer_config.json             # tokenizer 类与参数
├── vocab.json                        # BPE 词表(旧式 tokenizer 才单独放)
├── merges.txt                        # BPE 合并规则
├── special_tokens_map.json           # 特殊 token 映射(bos/eos/pad/unk)
├── added_tokens.json                 # 手动追加的 token
├── chat_template.jinja               # 对话模板(新版独立成文件)
└── preprocessor_config.json          # 多模态模型的图像/音频预处理配置
5.2 README.md
模型卡本质是一个 Markdown 文件,顶部 --- 包起来的一段 YAML 就是元数据。这部分直接驱动 HF 的筛选器、模型页展示、以及加载工具的自动推断。
---
language:
  - zh
  - en
thumbnail: "url to a thumbnail used in social sharing"
tags:
  - text-generation
  - qwen2
license: apache-2.0
datasets:
  - stanfordnlp/imdb
base_model: HuggingFaceH4/zephyr-7b-beta
library_name: transformers
pipeline_tag: text-generation
---
| 字段 | 作用 |
|---|
| 字段 | 作用 |
|---|---|
language | 语言代码列表,用于 hub 上的语言筛选 |
tags | 标签,决定模型页显示的 tag;可自定义(如 finance) |
license | 许可证标识,用于筛选与展示;自定义许可证写 license: other + license_name + license_link |
datasets | 训练所用数据集 Hub ID,模型页会显示 “Datasets used to train:” 并链接过去 |
base_model | 基座模型 ID;可以是列表(合并多个模型时) |
base_model_relation | 与基座的关系:adapter / merge / quantized / finetune。Hub 会自动推断,也可显式指定 |
library_name | 支持该模型的库(如 transformers、flair)。非 transformers 模型强烈建议显式写 |
pipeline_tag | 任务类型(如 text-generation),决定模型页用哪个 widget 和底层 API |
buckets | 关联的存储桶 ID |
thumbnail | 社交分享缩略图 |
5.3 config.json —— 架构配置
transformers 靠它决定加载哪个模型类、怎么搭网络。常见字段:
| 字段 | 含义 |
|---|---|
architectures | 架构类名,如 ["Qwen2ForCausalLM"] |
model_type | 模型类型,如 qwen2、llama(旧版 transformers 会因此报 KeyError) |
hidden_size | 隐藏层维度 |
num_hidden_layers | 层数 |
num_attention_heads / num_key_value_heads | Q 头数 / KV 头数(GQA 时二者不等) |
intermediate_size | FFN 中间维度 |
vocab_size | 词表大小 |
max_position_embeddings | 最大位置编码长度 |
rope_scaling | 长上下文外推配置,如 {"type": "yarn", "factor": 4.0, "original_max_position_embeddings": 32768} |
torch_dtype | 权重精度,如 bfloat16 |
tie_word_embeddings | 是否共享输入/输出 embedding |
quantization_config | 量化配置(GPTQ / AWQ / bitsandbytes 等) |
5.4 generation_config.json —— 生成参数
model.generate() 的默认超参,加载时一并读入:
{
“bos_token_id”: 151643,
“eos_token_id”: 151645,
“max_new_tokens”: 2048,
“temperature”: 0.7,
“top_p”: 0.8,
“top_k”: 20,
“repetition_penalty”: 1.05,
“do_sample”: true
}
5.5 权重文件与分片
| 文件 | 说明 |
|---|---|
model.safetensors | 小模型单文件,推荐格式 |
model-0000X-of-0000N.safetensors | 大模型分片(sharded checkpoint) |
model.safetensors.index.json | 分片索引 |
pytorch_model.bin | 旧式 PyTorch 权重,基于 pickle,存在安全风险,尽量避开 |
.gitattributes | 声明 *.safetensors 等走 Git LFS |
分片规则:save_pretrained() 会自动把超过 50GB 的 checkpoint 分片,可用 max_shard_size 调整阈值。分片并行加载,峰值内存只取决于模型大小(MoE 例外:内存 ≈ 模型大小 + 单层专家数)。
索引文件 model.safetensors.index.json 只有两个键:
metadata:存总大小,如{"total_size": 28966928384}weight_map:参数名 → 所属分片文件
{
  "metadata": { "total_size": 28966928384 },
  "weight_map": {
    "lm_head.weight": "model-00006-of-00006.safetensors",
    "model.embed_tokens.weight": "model-00001-of-00006.safetensors",
    "model.layers.0.input_layernorm.weight": "model-00001-of-00006.safetensors",
    "model.layers.0.mlp.down_proj.weight": "model-00001-of-00006.safetensors"
  }
}
5.6 Tokenizer 相关文件
| 文件 | 作用 |
|---|---|
tokenizer.json | 完整 tokenizer(词表 + 规则),加载最快,新模型基本只留这个 |
tokenizer_config.json | tokenizer 类名与参数,如 model_max_length、padding_side |
vocab.json + merges.txt | 旧式 BPE tokenizer 的词表与合并规则 |
tokenizer.model | SentencePiece(LLaMA 系)词表 |
special_tokens_map.json | bos / eos / pad / unk 的映射 |
added_tokens.json | 手动追加的特殊 token |
chat_template.jinja | 对话模板,把 [{role, content}] 渲染成模型需要的 prompt 格式;新版支持独立成文件 |
6. 模型文件解析方法
6.1 解析原则
不管什么格式,所有解析都遵循同一个顺序:
第 1 步  看魔数               →  确定「容器类型」
第 2 步  按容器结构拆层          →  找到「元数据区」和「张量数据区」
第 3 步  读元数据 → 索引数据     →  拿到张量名 / 形状 / dtype,再按需切片
为什么必须先看魔数? 因为扩展名会骗人:
.pth/.pt/.ckpt/.bin物理上可能是 pickle,也可能是 zip(取决于 PyTorch 版本).pb只是protobuf 序列化的约定扩展名,没有固定魔数,光看文件头判不出来.h5和 Keras 3 的.keras完全不是一个东西 —— 前者是 HDF5,后者是 zip.ckpt只是训练脚本的命名习惯(Lightning 等爱用),物理格式另有其事
命令:
xxd -l 32 model.pth     # 看前 32 字节的十六进制
file model.pth          # 系统级文件类型识别(部分环境支持)
6.2 魔数速查表
| 魔数(十六进制 / ASCII) | 容器类型 | 典型文件 | 怎么读 |
|---|---|---|---|
50 4b 03 04(PK..) | ZIP | torch 新格式 .pt/.pth、Keras3 .keras、.npz | zipfile / torch.load |
80 02 / 80 04 / 80 05 | Pickle | torch 老格式 .pt/.pth/.ckpt | torch.load |
89 48 44 46 0d 0a 1a 0a(\x89HDF\r\n\x1a\n) | HDF5 | Keras / TF .h5 .hdf5 | h5py.File / keras |
47 47 55 46(GGUF) | GGUF | llama.cpp / ollama 量化模型 | gguf.GGUFReader |
47 47 4d 4c(GGML) | GGML | llama.cpp 早期格式(已淘汰) | 转 GGUF 后再读 |
偏移 4 处为 54 46 4c 33(TFL3) | FlatBuffers | TFLite .tflite | tf.lite.Interpreter |
| 无固定魔数 | protobuf | TF .pb、ONNX .onnx | TF / onnx 库 + netron |
前 8 字节为小端 uint64 长度,其后紧跟 { | safetensors | HF 权重、LLM 分片 | safetensors.safe_open |
6.3 逐格式解析
6.3.1 PyTorch .pth / .pt / .ckpt
本质:torch.save 是 pickle 序列化,存的是Python 对象图,不是通用张量格式。所以 .pth 里可能装 dict、nn.Module,甚至一个整数。
两种物理格式:
A. 老格式(torch < 1.6,或 _use_new_zipfile_serialization=False)
开头: 80 02 <- pickle protocol 2
结构: 纯 pickle 流,张量字节内联在 pickle 里
B. 新格式(torch >= 1.6 默认)
开头: 50 4b 03 04(PK..) <- zip 容器
结构: <prefix>/data.pkl <- 对象图(pickle)
<prefix>/data/0,1,2... <- 每个张量的裸字节
<prefix>/version <- 格式版本
读取代码:
import torch, zipfile
# 方式一:官方加载(最常用)
sd = torch.load("model.pth", map_location="cpu")
sd = sd.get("state_dict", sd) # 解包 Lightning / 自训脚本的嵌套
for k, v in sd.items():
print(k, tuple(v.shape), v.dtype)
# 方式二:先看它到底是 zip 还是 pickle
if zipfile.is_zipfile("model.pth"):
with zipfile.ZipFile("model.pth") as z:
names = z.namelist()
prefix = next(n[:-len("data.pkl")] for n in names if n.endswith("/data.pkl"))
print("prefix =", prefix, "| 张量块数 =",
sum(1 for n in names if "/data/" in n and n.split("/data/")[-1].isdigit()))
6.3.2 TensorFlow / Keras .h5
本质:HDF5 —— 层级化的科学数据容器,像文件系统里的文件系统。Keras 把权重 + 模型结构(JSON 字符串)都塞进 HDF5 树里。
结构:
/                        attrs: keras_version, backend, model_config(JSON字符串)
  /model_weights/        每层权重
    /dense/
      dense/kernel:0     <- Dataset,真正的 ndarray
      dense/bias:0
  /optimizer_weights/    优化器状态(如果有)
读取代码:
import h5py
# 方式一:直接遍历(看结构最直观)
with h5py.File("model.h5", "r") as f:
print("根属性:", dict(f.attrs))
f.visititems(lambda n, o: print(
("D " if isinstance(o, h5py.Dataset) else "G ") + n,
(o.shape, o.dtype) if isinstance(o, h5py.Dataset) else ""))
# 方式二:官方加载(需要版本兼容)
# import tensorflow as tf
# model = tf.keras.models.load_model("model.h5")
# model.summary()
# 方式三:只抠权重成 numpy
weights = {}
with h5py.File("model.h5", "r") as f:
f.visititems(lambda n, o: weights.update({n: o[()]})
if isinstance(o, h5py.Dataset) and n.startswith("model_weights") else None)
6.3.3 TensorFlow .pb
本质:.pb = Protocol Buffers 二进制,TF 用它序列化计算图(GraphDef)。.pb 没有固定魔数。
两种完全不同的东西都叫 .pb:
A. 冻结图 frozen_graph.pb —— 单个文件
内容: GraphDef 消息(节点定义 + 权重,权重通常被 freeze 成 Const 节点嵌进去)
读取:
import tensorflow as tf
gd = tf.compat.v1.GraphDef()
gd.ParseFromString(open("frozen.pb", "rb").read())
print(len(gd.node), "个节点")
for n in gd.node[:10]:
print(n.name, n.op)
B. SavedModel —— 一个目录
saved_model.pb <- MetaGraphDef(图 + 签名)
variables/ <- 权重(variables.data-00000-of-00001 + .index)
assets/ <- tokenizer 等附属文件
读取:
m = tf.saved_model.load("saved_model_dir")
print(m.signatures.keys())
手工扫 protobuf 字段:
# protobuf 的 wire format: [tag varint][payload]
# tag = (field_number << 3) | wire_type
def scan(buf):
    i = 0
    while i < len(buf):
        shift, val = 0, 0
        while True:                                # 读 tag varint
            b = buf[i]; i += 1
            val |= (b & 0x7F) << shift
            if not (b & 0x80): break
            shift += 7
        field_no, wire_type = val >> 3, val & 0x07
        if wire_type == 2:                         # length-delimited
            shift, ln = 0, 0
            while True:                            # 读长度 varint
                b = buf[i]; i += 1
                ln |= (b & 0x7F) << shift
                if not (b & 0x80): break
                shift += 7
            print(f"field#{field_no} len={ln} -> {buf[i:i+ln][:40]!r}")
            i += ln
        else:
            break
6.3.4 ONNX .onnx
本质:也是 protobuf。顶层消息 ModelProto,嵌套结构:
ModelProto
  ir_version, producer_name, opset_import[]
  graph: GraphProto
      node[]          <- 算子节点(op_type, input[], output[])
      initializer[]   <- 权重常量 TensorProto(真正的权重在这)
      input[] / output[]
  metadata_props[]
读取代码:
import onnx
from onnx import numpy_helper
m = onnx.load("model.onnx")
onnx.checker.check_model(m)
print("ir_version:", m.ir_version, "| producer:", m.producer_name)
print("opset:", [(o.domain or "ai.onnx", o.version) for o in m.opset_import])
# 算子 + 连接关系
print(onnx.helper.printable_graph(m.graph))
# 权重清单
for t in m.graph.initializer:
arr = numpy_helper.to_array(t)
print(t.name, arr.shape, arr.dtype)
# 输入输出签名
print("输入:", [i.name for i in m.graph.input])
print("输出:", [o.name for o in m.graph.output])
printable_graph() 的输出是文本版计算图 —— 不用开 netron 也能看清算子连接,形如:
graph demo (%X[FLOAT, 1x3]) initializers (%W[FLOAT, 3x4] %B[FLOAT, 4]) {
  %XW = MatMul(%X, %W)
  %Y = Add(%XW, %B)
  return %Y
}
验证 / 推理:
import onnxruntime as ort
sess = ort.InferenceSession("model.onnx")
print("输入:", [(i.name, i.shape) for i in sess.get_inputs()])
print("输出:", [(o.name, o.shape) for o in sess.get_outputs()])
6.3.5 safetensors
from safetensors import safe_open
# 方式一:懒加载(不读全量)
with safe_open("model.safetensors", framework="pt", device="cpu") as f:
print(list(f.keys()))
t = f.get_tensor("model.embed_tokens.weight")
print(t.shape, t.dtype)
# 方式二:numpy 全量
from safetensors.numpy import load_file
sd = load_file("model.safetensors")
# 方式三:手撕头部(理解格式,不依赖库)
import struct, json
with open("model.safetensors", "rb") as f:
n = struct.unpack("<Q", f.read(8))[0]
header = json.loads(f.read(n))
for k, v in header.items():
if k != "__metadata__":
print(k, v["dtype"], v["shape"], v["data_offsets"])
6.3.6 GGUF
解析入口:
from gguf import GGUFReader
r = GGUFReader("model.gguf")
print("字段数:", len(r.fields), "| 张量数:", len(r.tensors))
# 元数据(架构、名称、量化版本、超参)
for k in ("general.architecture", "general.name", "general.file_type",
"llama.block_count", "llama.embedding_length", "tokenizer.ggml.model"):
if k in r.fields:
print(k, "=", r.fields[k].contents())
# 张量 + 量化类型(Q4_K / Q6_K / F32 ...)
for t in r.tensors[:5]:
print(t.name, list(t.shape), t.tensor_type.name)
只靠头部、不装 gguf 库也能读基本信息:
import struct
with open("model.gguf", "rb") as f:
    assert f.read(4) == b"GGUF"
    version = struct.unpack("<I", f.read(4))[0]
    n_tensors = struct.unpack("<Q", f.read(8))[0]
    n_kv = struct.unpack("<Q", f.read(8))[0]
print(version, n_tensors, n_kv)
量化命名规则:Q4_K_M 里的 Q4 = 4-bit;后缀 _K 是 k-quant 系列,_M / _S / _L 表示 medium / small / large 混合精度等级。
6.4 大模型分片怎么还原
HF 格式的大模型常被切成多片,靠 model.safetensors.index.json 索引关联。
还原思路:
import json
from collections import defaultdict
idx = json.load(open("model.safetensors.index.json"))
wmap = idx["weight_map"]
# 1. 每个分片负责哪些张量
per_shard = defaultdict(list)
for name, shard in wmap.items():
per_shard[shard].append(name)
# 2. 按需只加载某个张量
import struct
def load_one(shard, tensor):
import numpy as np
with open(shard, "rb") as f:
n = struct.unpack("<Q", f.read(8))[0]
header = json.loads(f.read(n))
base = 8 + n
s, e = header[tensor]["data_offsets"]
f.seek(base + s)
raw = f.read(e - s)
shape = header[tensor]["shape"]
return np.frombuffer(raw, dtype=np.float16).reshape(shape)
load_one() 就是零拷贝只读一片的实际用法 —— 只想看某一层权重时,完全没必要把整份 15GB 读进内存。
GGUF 分片更简单:llama-cli -m <第一个分片路径>,llama.cpp 会自动合并。