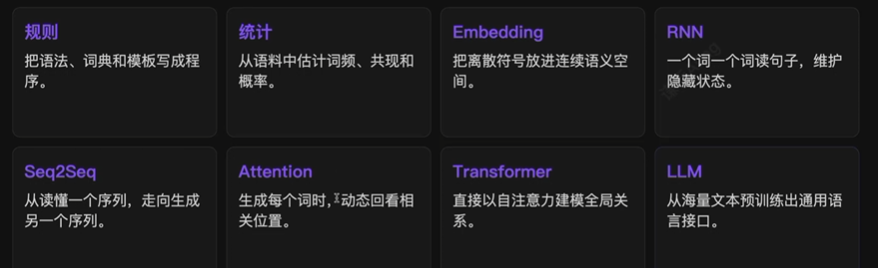
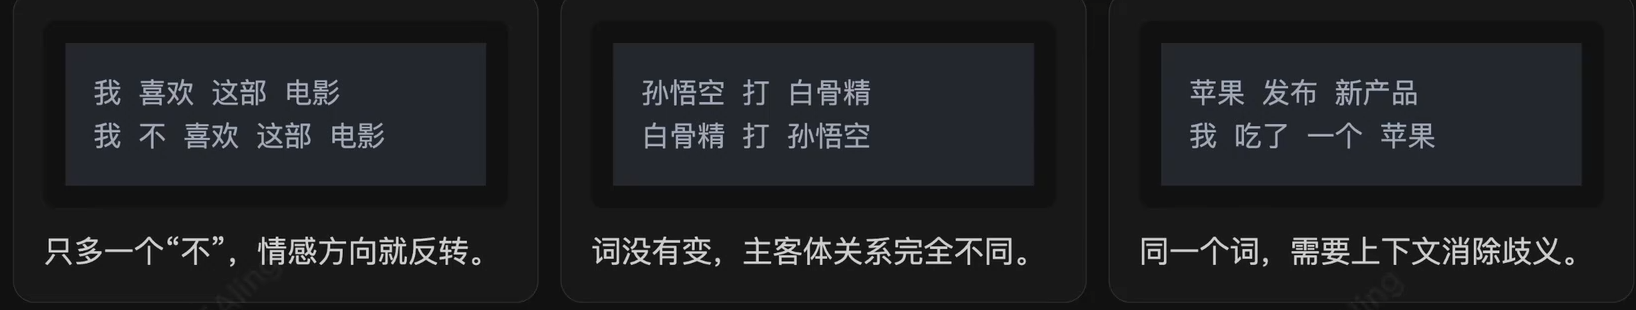
2017 年,Google 在论文《Attention Is All You Need》中提出了 Transformer。今天我们接触到的大语言模型,绝大多数都可以追溯到 Transformer。
但 Transformer 并不是凭空出现的,它最初要解决的仍然是自然语言处理中的一个经典问题:如何把一个序列转换成另一个序列。
与当时主流的序列模型不同,Transformer 不再依赖循环神经网络(Recurrent Neural Network,RNN)沿序列逐步传递隐藏状态,而是让注意力机制承担不同位置之间的信息交换。
以机器翻译为例,整个过程可以概括为:
- 转换输入——Embedding: 源序列中的 Token 首先经过 Input Embedding,被转换成模型可以处理的向量表示。
- 理解源序列——Encoder: Encoder 读取源序列,为每个输入 Token 生成包含上下文信息的表示。
- 生成目标表示——Decoder: Decoder 读取 Encoder 的输出,并结合当前已经生成的目标前缀,生成当前位置的隐藏表示。
- 映射到词表——Linear: Linear 层将 Decoder 的隐藏表示映射到词表空间,为词表中的每个候选 Token 打分。
- 转换为概率——Softmax: Softmax 将这些分数转换成总和为 1 的概率分布,表示下一个位置生成各个 Token 的概率。
- 预测下一个 Token——自回归生成: 模型根据概率分布选择下一个 Token,并将它加入目标前缀。下一轮预测时,更新后的目标前缀经过 Output Embedding 转换成向量,再输入 Decoder。模型重复上述过程,直到生成
<EOS>。
从整体流程来看,Transformer 与 Seq2Seq 并没有本质区别:Encoder 负责理解输入,Decoder 负责逐步生成输出。真正发生变化的是 Encoder 和 Decoder 内部生成上下文表示的方式。
Positional Encoding:为 Token 加入位置信息
但 Transformer 不再像 RNN 一样沿序列逐步计算,Self-Attention 会同时处理并比较不同位置的 Token。这样虽然消除了顺序计算的依赖,却也意味着模型无法从计算顺序中获得位置信息。
因此,Transformer 还需要为每个 Token 提供位置信息。它会对序列中的位置进行编码,并将位置编码(Positional Encoding)直接加到对应 Token 的 Embedding 上,使进入第一层 Encoder 和 Decoder 的向量同时包含 Token 信息和位置信息。
假设  表示序列中第
 个位置的 Token,那么它进入第一层 Encoder 或 Decoder 前的表示为:
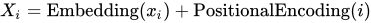
Self-Attention:让输入位置直接交换信息
在 RNN 中,只有得到前一个位置的隐藏状态,才能继续计算下一个位置。句尾的词想要获得句首的信息,这些信息必须经过中间多个隐藏状态逐步传递。序列越长,传递路径越长,同一层中的不同位置也无法同时完成计算。
Self-Attention 改变了这种信息传递方式。输入序列中的每个 Token 都会根据自身表示生成 Query,与整个序列中各个位置的 Key 计算匹配程度,再根据得到的注意力权重对相应的 Value 进行加权汇总。这样,每个 Token 都可以直接读取其他位置的信息,生成融合上下文的新表示。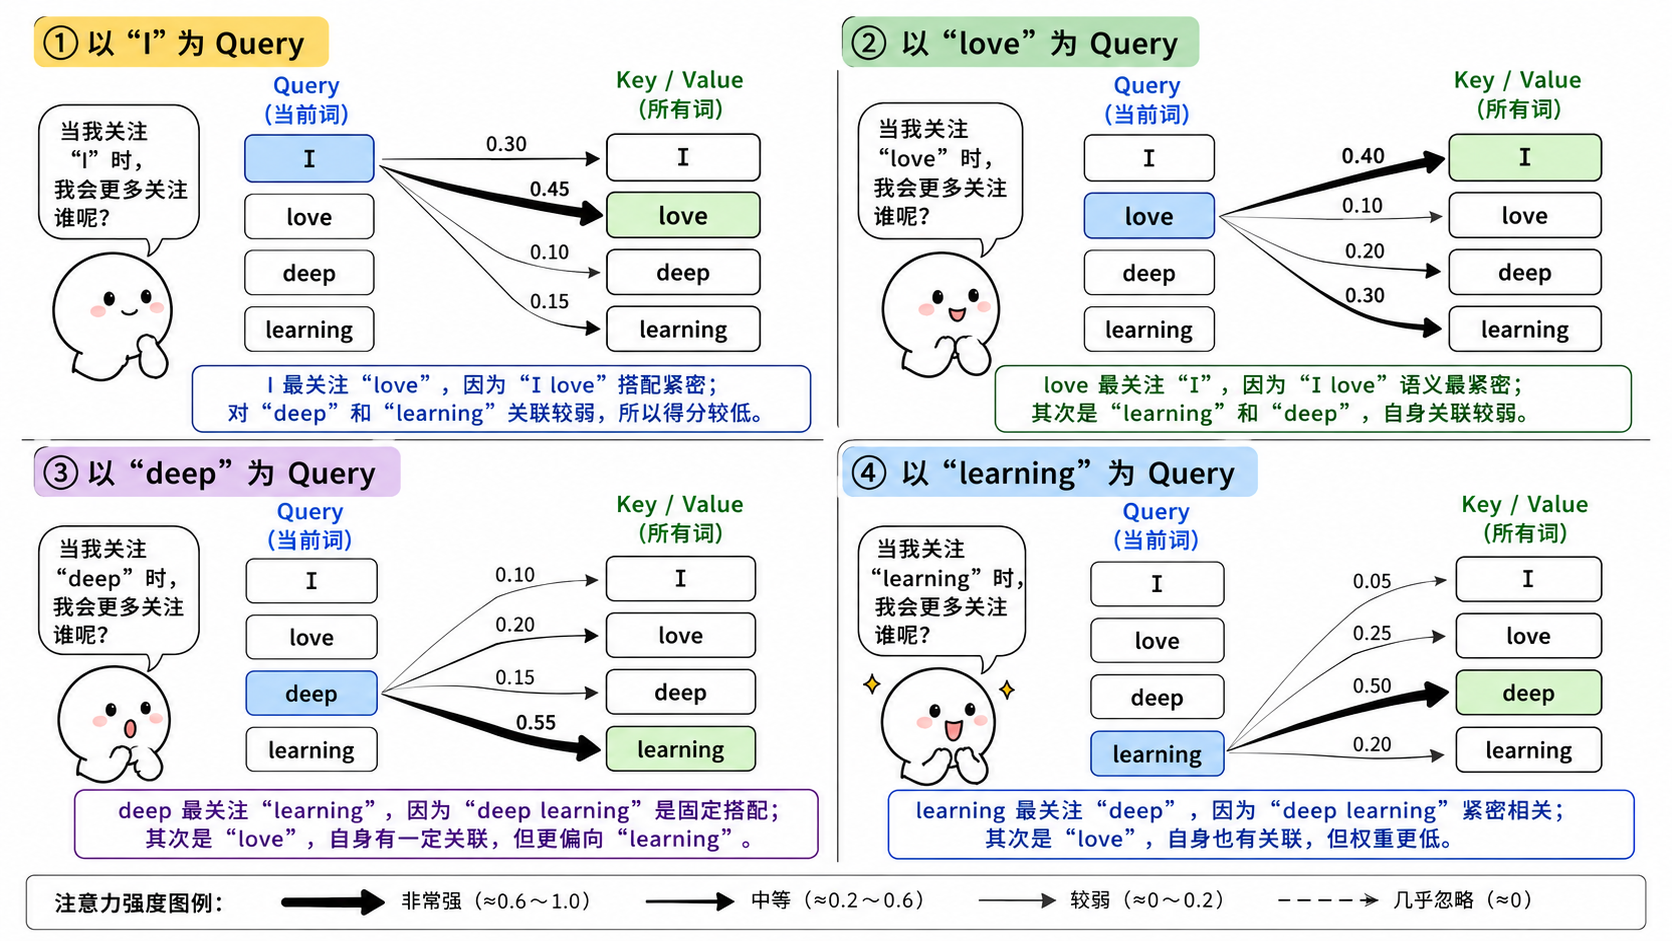
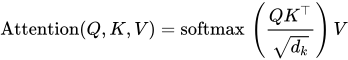
在同一层中,各个位置 Token 关系的计算不需要等待前一个位置的结果。只要整段输入已经存在,所有 Token 的注意力计算就可以组织成矩阵并行完成,这正是 Transformer 相比 RNN 更适合并行训练的重要原因。
Transformer 还使用了多头注意力,多组不同的参数对同一段输入进行映射,让多个 Attention Head 分别从不同的表示空间提取信息,最后再将各个 Head 的结果拼接并融合。
Add & Norm:让信息稳定地穿过深层网络
架构图中的 Nx 代表可以堆叠多层,Self-Attention 完成了不同 Token 之间的信息交换,但随着网络不断堆叠,原有信息可能在连续变换中逐渐丢失,各层输出的数值分布也可能发生较大变化。因此,Transformer 会在每个子层之后加入 Add & Norm。
其中,Add 表示残差连接。假设子层的输入为  ,子层完成的变换为
 ,那么残差连接会把原始输入直接加回子层输出:

Norm 表示层归一化(Layer Normalization,LayerNorm)。它会对每个 Token 隐藏表示内部的各个维度进行归一化,将数值调整到相对稳定的范围,减少网络层层堆叠时数值分布的剧烈变化。
Add & Norm 的过程可以写成:
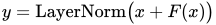
Encoder 中的 Self-Attention 和 FFN 后面都跟着 Add & Norm,Decoder 中的掩码自注意力、交叉注意力和 FFN 后面也分别使用 Add & Norm,作用同样是保留原始信息、稳定数值分布,让信息能够顺利穿过多层 Decoder。
FFN:进一步加工每个位置的信息
经过 Encoder 的 Self-Attention 后,每个 Token 已经从序列中的其他位置汇总了与自己相关的信息。但注意力主要解决的是“应该关注哪些位置、从这些位置读取多少信息”,得到的上下文表示还需要进一步加工,才能形成更有表达能力的特征。
Transformer 使用前馈神经网络对这些信息进行重新组合和转换。FFN 由两个线性层组成,中间加入一个 ReLU 激活函数:
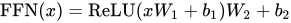
整个过程可以分为三步:
- 第一个线性层将隐藏表示映射到更高的维度,提供更宽的特征空间;
- ReLU 引入非线性,使网络能够学习更复杂的特征转换;
- 第二个线性层将结果映射回原来的隐藏维度,以便与残差连接相加,并继续传递给下一层。
也就是说 Self-Attention 负责在不同 Token 之间交换信息,FFN 负责进一步加工每个 Token 已经获得的信息。
FFN 处理完成后,数据会再次经过 Add & Norm,然后继续进入下一层 Encoder。经过多层 Encoder 的信息交换和加工,模型最终会为源序列中的每个 Token 生成一个上下文表示。这些表示经过线性映射后,将作为 Decoder Cross-Attention 使用的 Key 和 Value。
Masked Self-Attention:训练时也不能看见未来
在推理阶段,Decoder 每次只能获得已经生成的目标前缀,未来的 Token 尚不存在,因此本来就无从读取。掩码真正需要解决的是训练阶段的问题。
训练时,为了并行计算所有位置,模型不会像推理时一样逐个生成 Token,而是通过 Teacher Forcing,一次性把右移后的完整目标序列交给 Decoder
但问题也随之出现:既然完整的目标序列已经放进 Decoder,如果不加任何限制,用于预测“喜欢”的位置就可能直接读取后面的“喜欢”,相当于提前看到了正确答案。模型可能由此找到一条训练时有效、推理时却无法使用的捷径。
因此,掩码自注意力会在 Self-Attention 的基础上增加因果掩码(Causal Mask),限制每个位置只能关注自己以及前面的位置。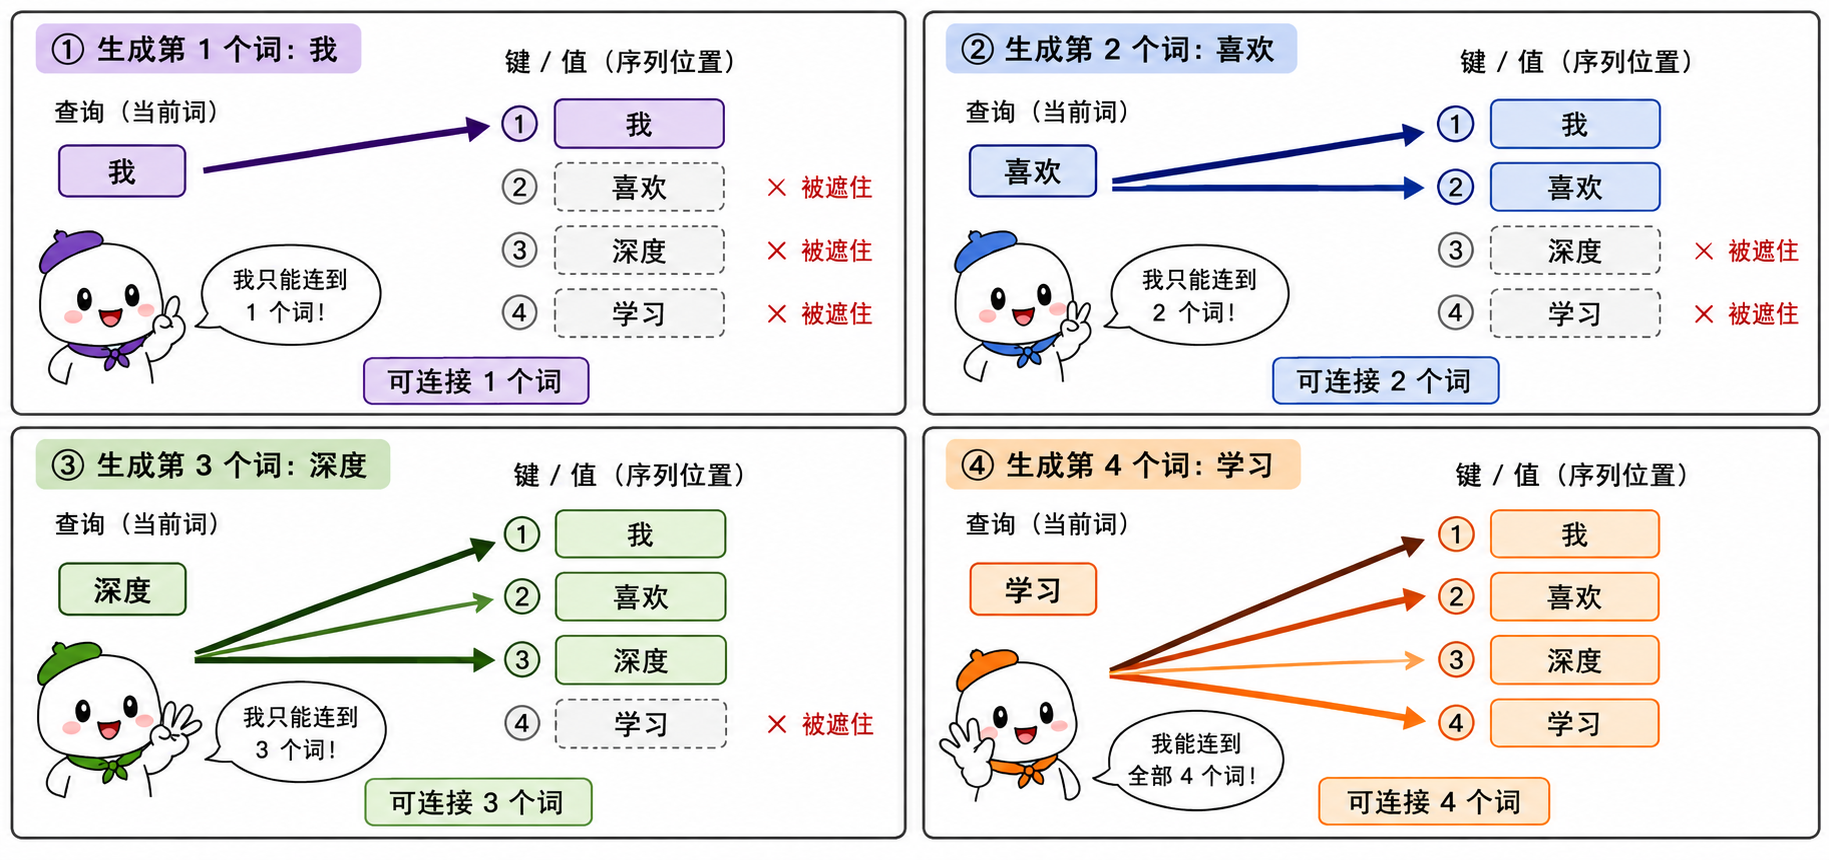
经过掩码自注意力后,Decoder 会为每个位置生成一份只包含目标前缀信息的上下文表示。它记录了目标序列到当前位置为止已经出现的内容,接下来将作为 Query,通过交叉注意力从 Encoder 输出中寻找预测下一个 Token 所需要的源序列信息。
Cross-Attention:让 Decoder 查询 Encoder
掩码自注意力整理了已经生成的目标内容,但只看目标前缀还不足以完成翻译。Decoder 还需要知道源序列表达了什么,因此接下来要通过交叉注意力读取 Encoder 的输出。
这一步与 Seq2Seq Attention 的思想如出一辙,Decoder 先描述当前需要什么信息,再与 Encoder 保存的源序列信息进行匹配,最后取出相关内容。
在 Cross-Attention 中
- Query 来自 Decoder 掩码自注意力产生的目标序列上下文表示;
- Key 来自 Encoder 输出的源序列上下文表示;
- Value 同样来自 Encoder 输出的源序列上下文表示。
可以简化写成:
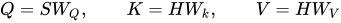
其中, 表示 Decoder 根据目标前缀生成的上下文表示,
 表示 Encoder 输出的源序列上下文表示。
Linear 和 Softmax:把隐藏表示变成 Token 概率
Linear 会把 Decoder 隐藏表示映射到词表空间,为每个位置输出打分,随后Softmax 将这些分数转换成总和为 1 的概率分布。
推理时,模型会根据这个概率分布选择下一个 Token,将它加入目标前缀,再次送入 Decoder,继续预测后面的内容。这个不断把已生成结果作为下一步输入的过程,就是自回归生成。
训练阶段由于正确的目标序列已经存在,Decoder 可以同时得到各个位置的输出,并行计算它们在词表上的概率和训练误差;推理阶段则只能在获得前一个 Token 后继续生成下一个 Token。因此,Transformer 消除的是已知序列内部的循环计算依赖,并没有消除自回归生成本身的先后顺序。
总结
编码器
- 源序列进入 Encoder 之前,先经过 Embedding 并加入位置信息
- Encoder 使用 Self-Attention 让源序列中的不同位置直接交换信息
- 再通过 Add & Norm 和 FFN 继续加工每个位置的表示,最终输出一组源序列上下文表示
解码器
- 目标前缀进入 Decoder 后,同样先经过 Embedding 和位置编码
- Masked Self-Attention 生成目标前缀的上下文表示,并由它进一步映射得到 Cross-Attention 的 Q
- Cross-Attention 再使用来自 Decoder 的 Q 查询来自 Encoder 的 K 和 V
- 经过后续的 FFN 和 Add & Norm,Decoder 得到用于预测 Token 的隐藏表示
- 最后由 Linear 和 Softmax 生成词表概率
注意力究竟在做什么
Transformer 中使用了三类注意力:编码器中的自注意力、解码器中的掩码自注意力和交叉注意力。
Attention 会计算序列中不同位置之间的匹配关系,再按照匹配程度读取并汇总信息,为每个 Token 生成新的上下文表示。
在 Attention 之前,每个 Token 的向量主要表示自身的语义和位置;经过 Attention 之后,每个 Token 的新向量已经融合了序列中其他相关位置的信息。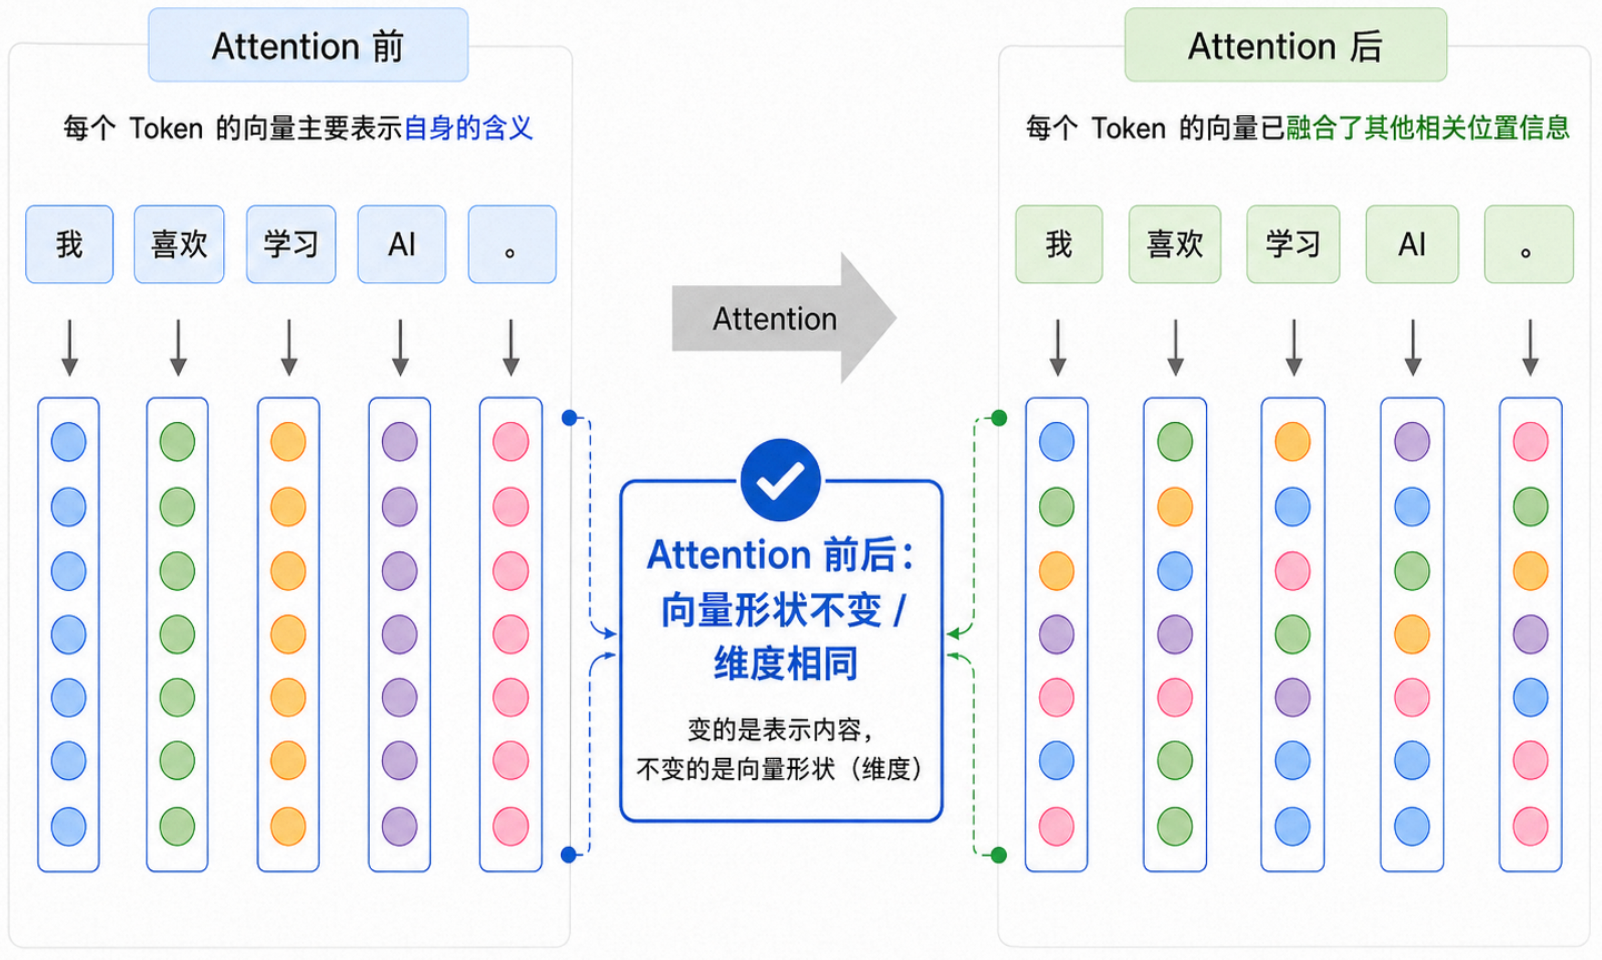
相较于基于cnn架构的seq2seq,Transformer 完成的是相同的任务,只是不再使用 RNN 逐步生成隐藏状态,而是把理解序列这件事本身也交给了 Attention。整体流程可以概括为:
- Encoder 使用自注意力处理输入序列,生成输入序列的上下文表示;
- Decoder 使用掩码自注意力处理已经生成的输出序列;
- Decoder 使用交叉注意力,根据当前生成状态读取输入序列的信息;
- 经过 FFN、线性映射和 Softmax,预测下一个 Token。
三类注意力内部使用的是同一种计算机制,主要区别在于 Query、Key 和 Value 来自哪里。
| 注意力类型 | Query 来源 | Key、Value 来源 | 主要作用 |
|---|---|---|---|
| 自注意力 | 输入序列 | 输入序列 | 生成输入序列的上下文表示 |
| 掩码自注意力 | 输出序列 | 输出序列 | 生成当前输出前缀的上下文表示 |
| 交叉注意力 | Decoder | Encoder | 根据当前生成状态读取输入序列 |
输入序列预处理
在进入 Encoder 之前,输入序列会首先经过 Embedding 和 Positional Encoding 处理,转换成一个序列表示矩阵。
I love deep learning
假设模型使用 512 维向量表示每个 Token,那么这个序列会形成一个  的矩阵,矩阵中的每一行对应一个 Token,包含这个 Token 的语义和位置信息:
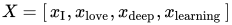
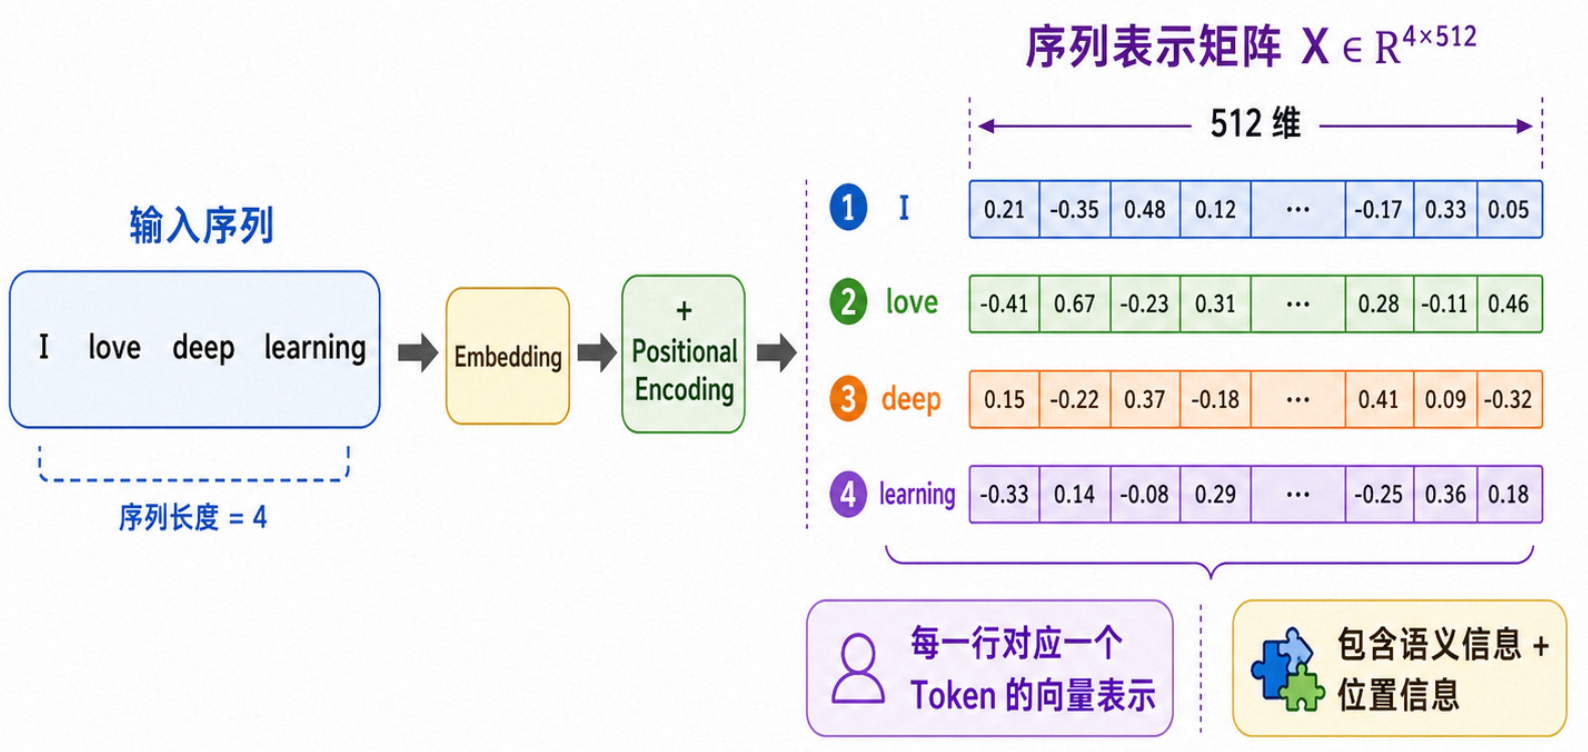
此时,每一行主要描述的仍然是对应 Token 自身。例如, 包含
learning 的语义和位置,却还没有直接融合 I、love 和 deep 的信息。
但一个 Token 在句子中的含义和作用,往往取决于它与其他 Token 的关系。learning 前面的 deep 修饰了它,love 则描述了 I 与 deep learning 之间的关系。
Self-Attention 要做的事情,就是让每个位置观察整个序列,根据它与其他位置的关系,重新生成一个包含上下文信息的向量。
Q、K、V 是输入矩阵的三种投影
为了计算不同位置之间的关系,模型会学习三组参数矩阵:
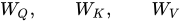
输入矩阵  分别与它们相乘,得到 Query、Key 和 Value:
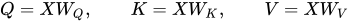
矩阵乘法会一次完成所有 Token 的线性投影,因此  、
 、
 中仍然各有一行对应序列中的一个 Token。可以这样理解三种投影:
- Query:描述当前位置在更新自身表示时,希望寻找什么信息;
- Key:描述当前位置提供了哪些可以参与匹配的特征;
- Value:描述匹配成功后,当前位置真正提供给其他位置的内容。
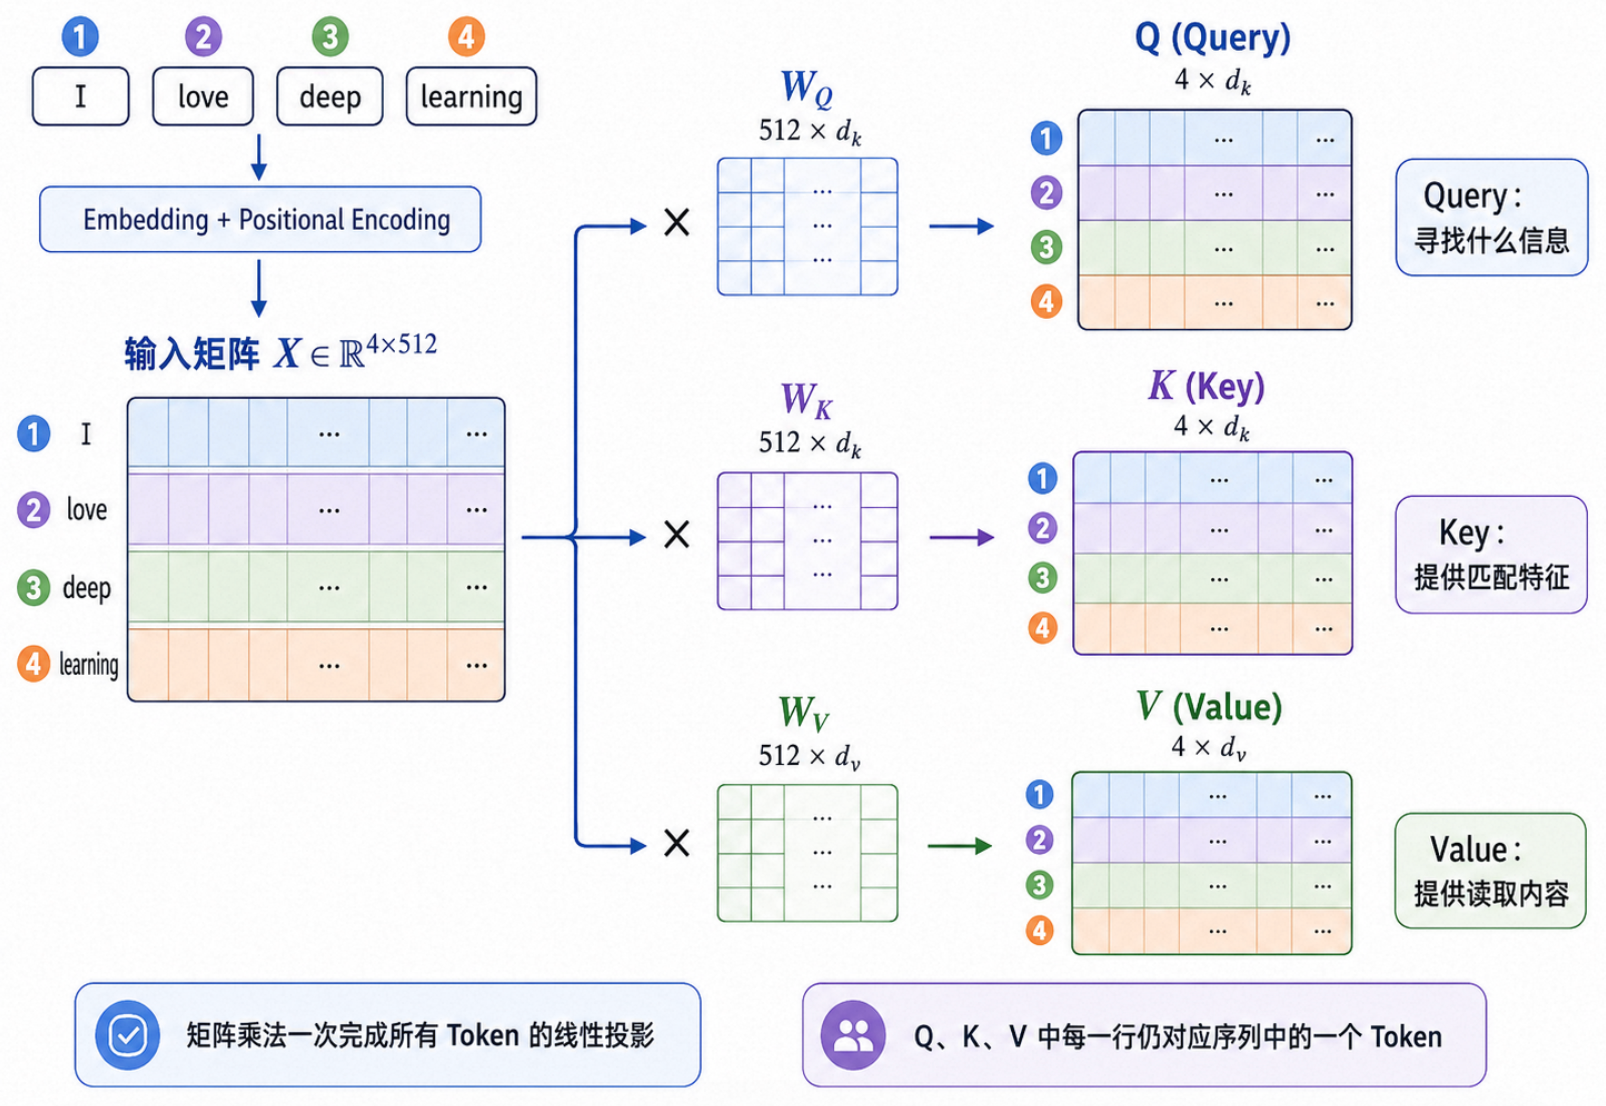
这里的“寻找”“提供”只是为了帮助我们理解 Attention 的信息流。Query、Key 和 Value 都是模型训练出来的向量,我们无需把其中某个具体维度直接解释成一种固定的人类语义。
一个 Token 如何读取整个序列
下面以 learning 为例,观察它如何通过 Self-Attention 生成新的上下文表示。
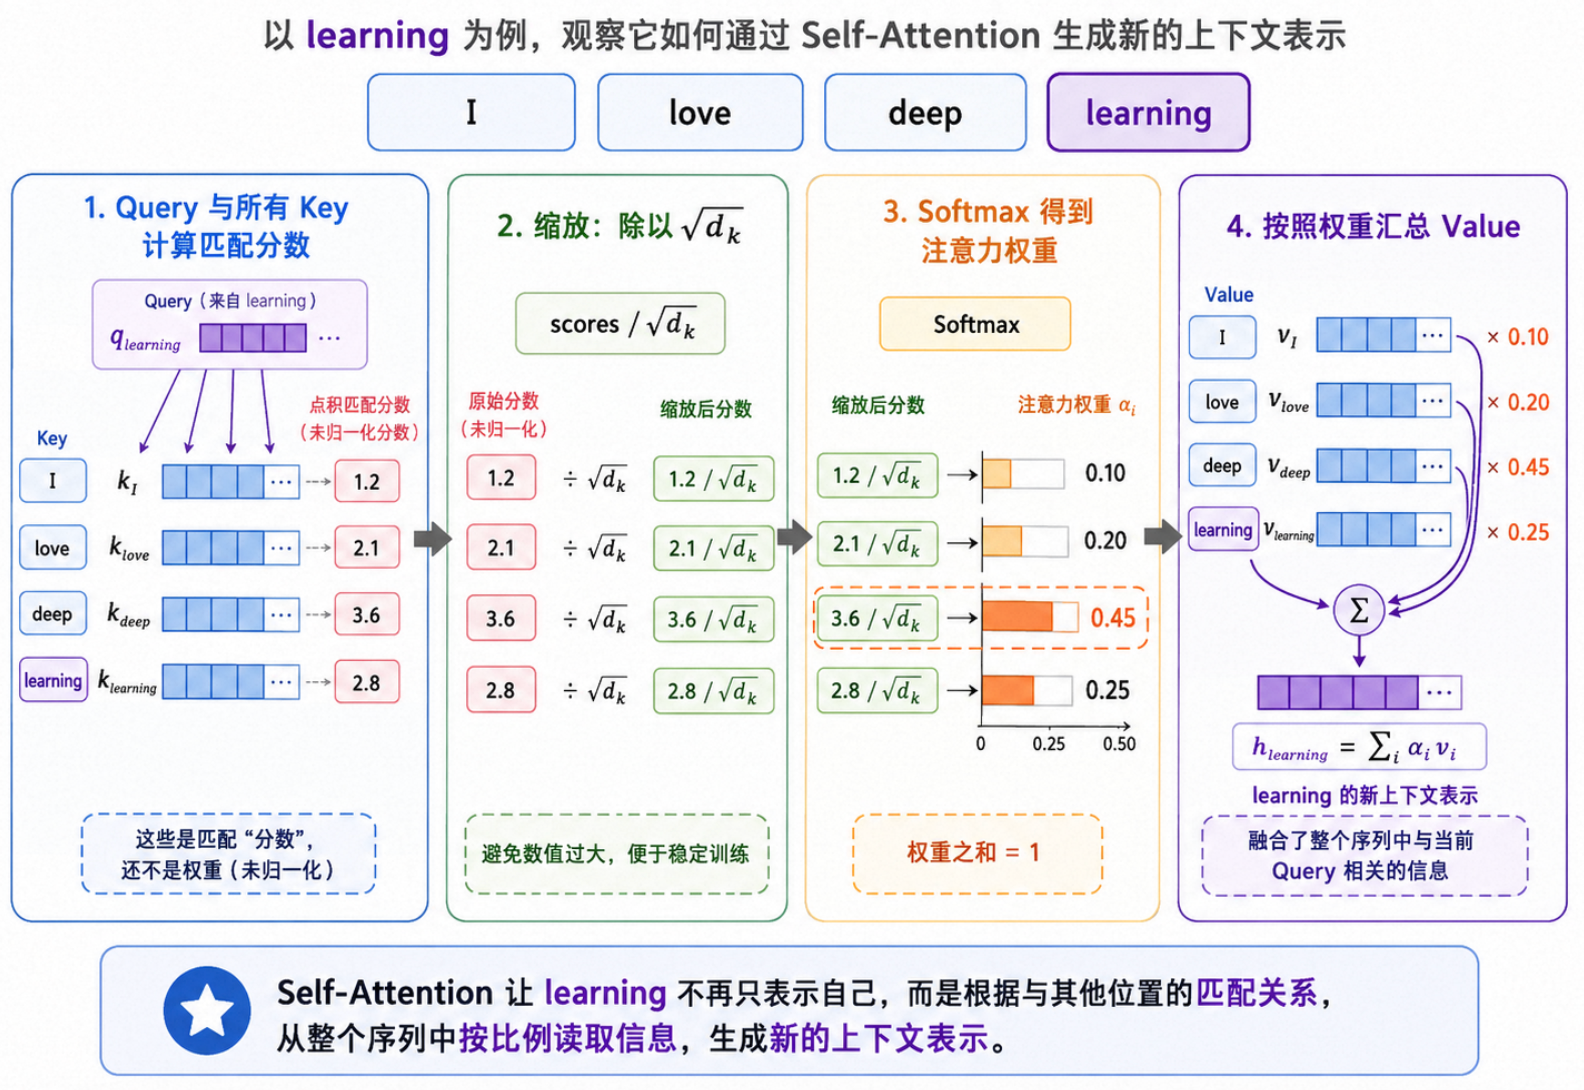
1. Query 与所有 Key 计算匹配分数
取出 learning 对应的 Query 向量  ,分别与序列中所有 Token 的 Key 做点积:
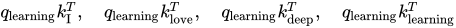
这些点积结果表示 learning 的 Query 与各个位置的 Key 有多匹配。这里得到的只是匹配分数,还不是最终的信息读取比例。
2. 除以 
随着向量维度增加,点积结果的数值通常也会增大。如果直接输入 Softmax 计算,可能使输出分布过于集中,导致梯度变小,影响训练稳定性。
因此,Transformer 会把点积结果除以进行缩放, 表示当前注意力头中 Query 和 Key 的向量维度。
3. 使用 Softmax 得到注意力权重
缩放后的匹配分数经过 Softmax,被转换成一组总和为 1 的注意力权重:
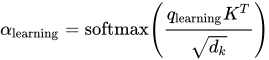
这些权重表示:为了更新 learning 的表示,当前注意力头应该从各个位置读取多少信息。例如,模型可能为 deep 分配较高权重,因为它与 learning 共同构成了 deep learning。
4. 按照权重汇总 Value
得到注意力权重之后,模型会按照相应比例,对所有位置的 Value 进行加权求和:
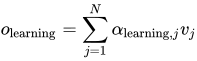
最终得到的  ,就是
learning 在这个注意力头中生成的新表示。它不再只包含 learning 自身的信息,还融合了 I、love、deep 和自身 Value 中与当前 Query 相关的内容。
使用矩阵从一个 Token 扩展到整个序列
序列中的每个 Token 都需要经历相同的过程:
- 使用自己的 Query 与所有位置的 Key 计算匹配分数;
- 通过 Softmax 把匹配分数转换成注意力权重;
- 按照权重对所有位置的 Value 加权求和;
- 得到当前位置新的上下文表示。
使用矩阵乘法,可以一次完成整个序列的计算。
首先计算注意力权重矩阵:
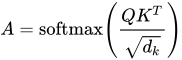
如果序列中有 个 Token,那么:

矩阵 的第行、第
 列,表示第个位置在更新自身表示时,对第个位置分配的注意力权重。
接下来模型使用对 Value 进行加权汇总:

合并后,就是我们经常看到的缩放点积注意力公式:
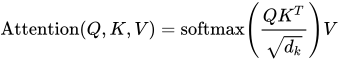
输出矩阵 中的每一行,都是一个 Token 融合上下文信息之后的新表示。
因此,Attention 的完整作用不只是判断哪些词更重要,而是先计算不同位置之间的匹配关系,再按照这些关系重新组织信息,生成整个序列新的上下文表示。
掩码自注意力:理解已经生成的内容
Decoder 中的掩码自注意力与 Encoder 自注意力使用相同的计算过程,它的作用是生成目标序列的上下文表示。两者的区别在于 Decoder 在训练时可以一次接收到完整的目标序列。如果不做任何限制,前面的位置就可能直接读取后面的正确答案。
因此,模型需要使用因果掩码遮挡未来位置,使第  个位置只能关注自己以及它之前的 Token,不能读取后面的内容。也就是说掩码是为了防止训练时出现目标信息泄漏,使模型训练时每个位置的可见范围与推理时自回归生成时保持一致。
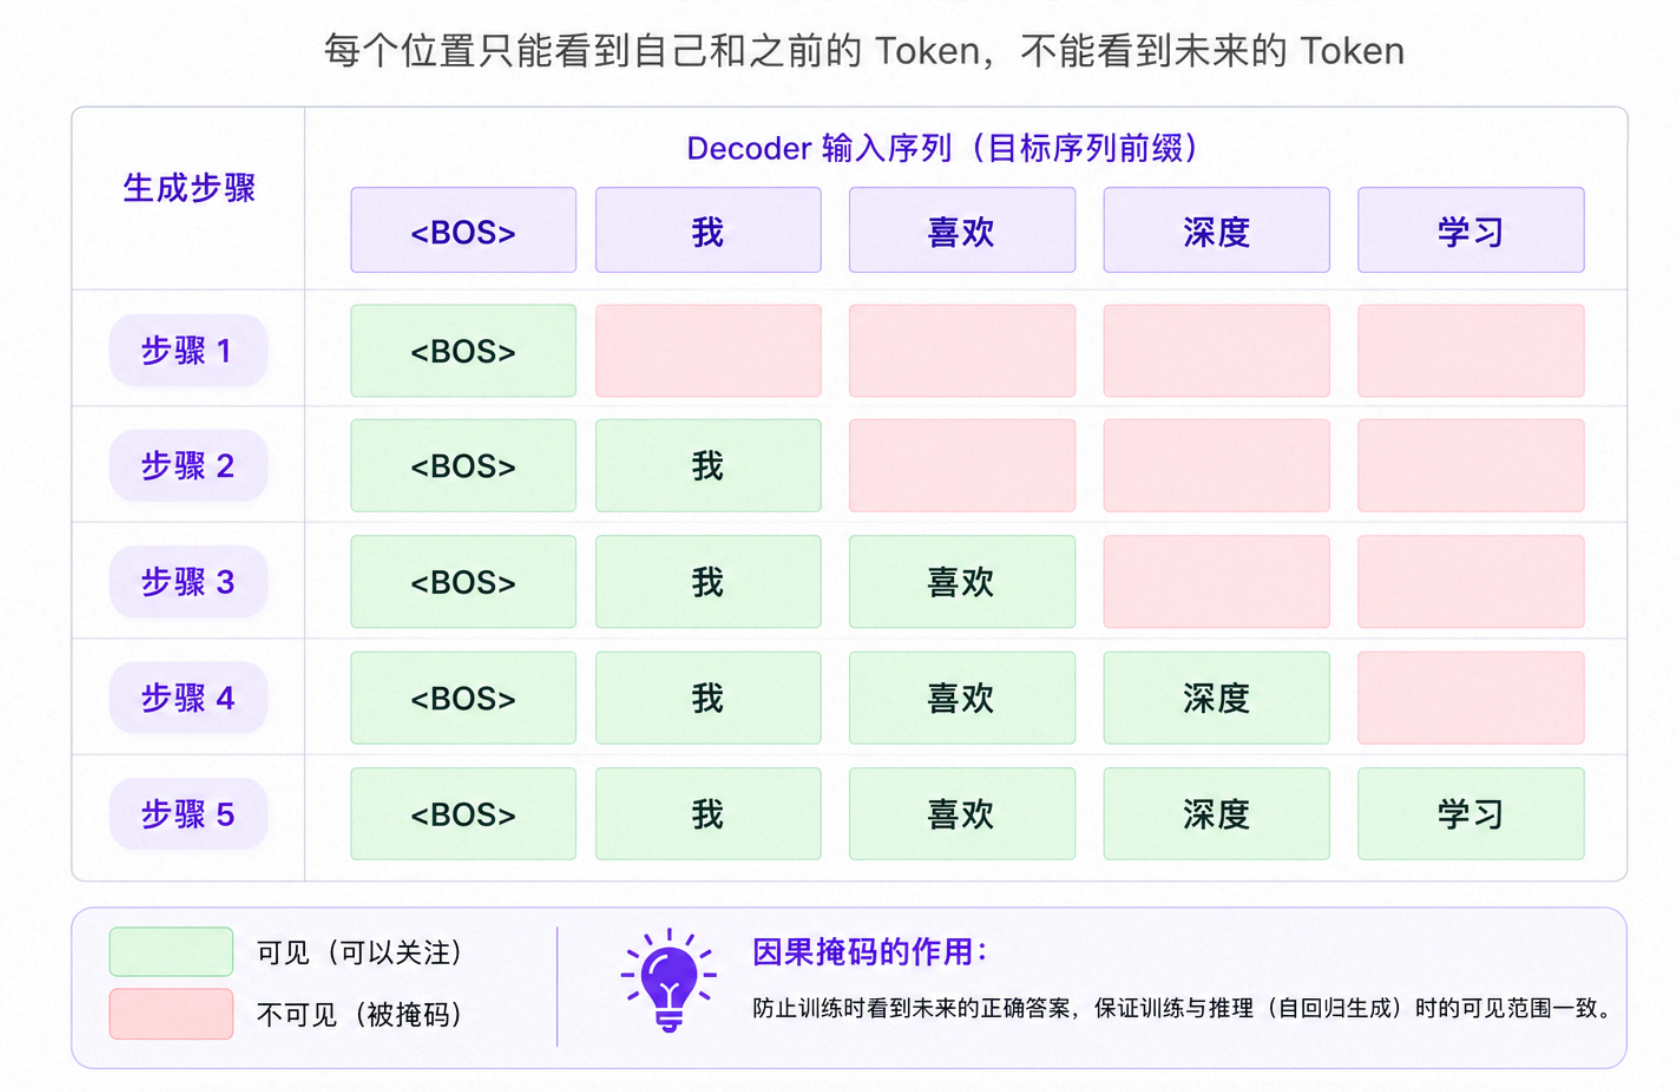
假设需要把下面的序列翻译成中文:
I love deep learning
推理刚开始时,Decoder 的输入只有:
<BOS>
经过 Embedding、Positional Encoding 和掩码自注意力之后,Decoder 会得到 <BOS> 对应的表示。
生成“我”以后,Decoder 的输入变为:
<BOS> 我
此时,“我”所在位置可以读取 <BOS> 和自身的信息,从而生成一个包含当前整个输出前缀信息的新表示。
加入掩码后的 Attention 可以简化表示为:
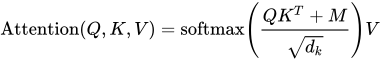
其中, 是因果掩码矩阵。允许关注的位置取 0,需要遮挡的位置取负无穷。经过 Softmax 后,被遮挡位置的注意力权重会变成 0。
需要注意的是,虽然推理时通常使用最新位置的表示预测下一个 Token,但这个表示已经通过掩码自注意力融合了当前整个生成前缀的信息。因此,它不是只表示“我”这个 Token,而是表示模型当前生成到哪里的整体状态。
交叉注意力:根据当前状态读取输入序列
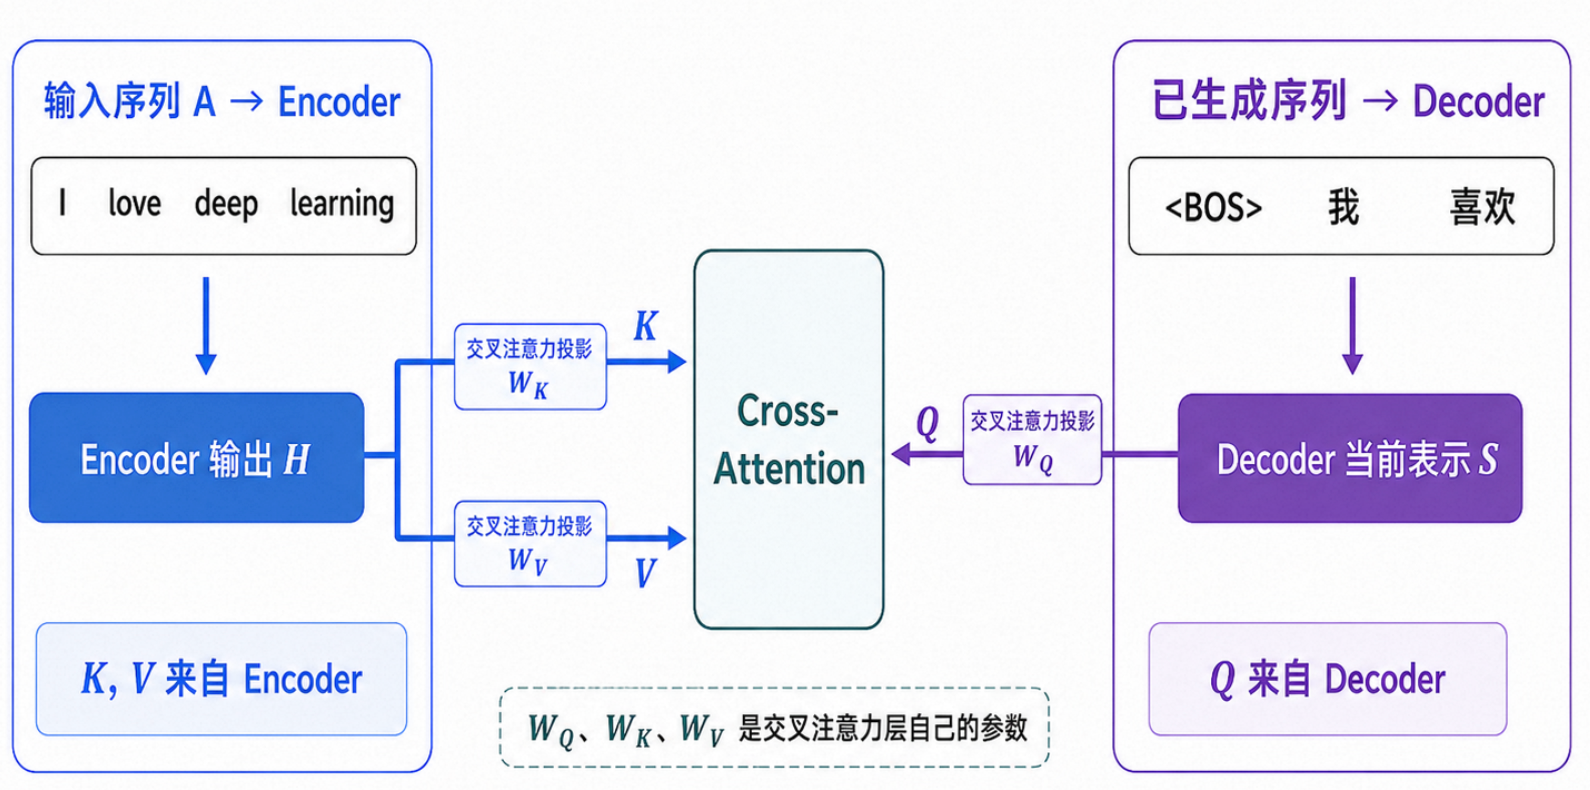
经过掩码自注意力之后,Decoder 已经形成了当前输出序列的上下文表示,但它还需要回到输入序列中,读取预测下一个 Token 所需的信息,这就要进入交叉注意力。
之所以称为交叉注意力,是因为 Query 与 Key、Value 来自两个不同的序列。交叉注意力中 Q、K、V 的来源分别是:
- Query 来自 Decoder 的当前序列表示;
- Key 和 Value 来自 Encoder 的最终输出。
假设 Encoder 对输入序列生成了上下文表示 ,Decoder 经过掩码自注意力后生成了表示  ,那么交叉注意力中的 Q、K、V 为:
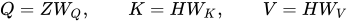
随后仍然使用相同的 Attention 公式:
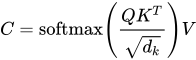
这个过程可以理解为:Decoder 根据当前已经生成的内容形成 Query,再用它查询 Encoder 对输入序列的表示,得到预测下一个 Token 所需的源序列信息。
Multi-Head Attention 的工作流程
在单头 Attention 中,输入序列表示经过三组参数矩阵得到 Query、Key 和 Value:
然后计算:
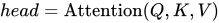
Multi-Head Attention 的思路是在同一个输入序列上并行进行多次 Attention,让不同的 Head 从不同较低提取特征,形成自己对序列理解的匹配关系,最后再把多个 Head 得到的结果组合起来。
但如果多个 Head 使用完全相同的 Q、K、V,那么它们计算出来的结果也不会有什么区别。为了让不同 Head 能够学习不同的匹配方式,模型会为每个 Head 分别学习一组独立的投影参数。对于第个 Head:
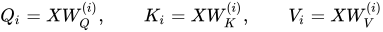
每个 Head 再使用自己的 Query、Key 和 Value 独立完成一次 Attention:
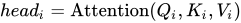
如果模型一共使用 个 Head,就会得到
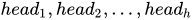 这些不同的输出。它们随后被拼接到一起,并经过一次线性映射,重新形成统一的序列表示:
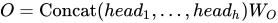
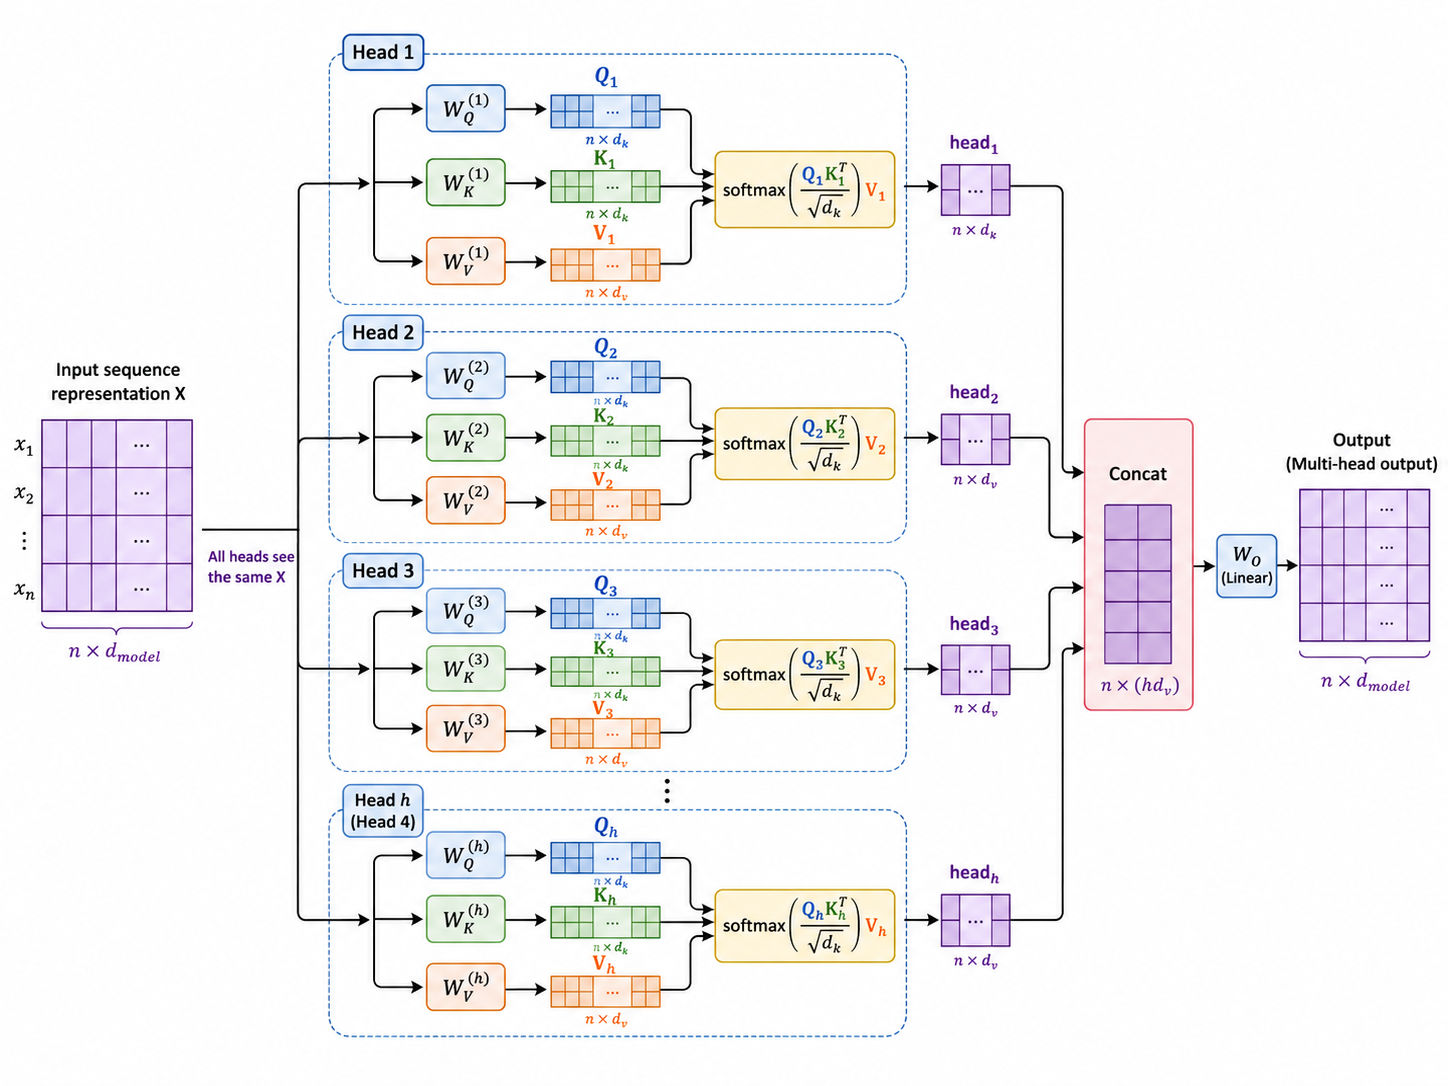
Multi-Head Attention 对同一个输入序列经过多组不同的 Q、K、V 投影,分别完成 Attention,再将多个 Head 的结果合并成一个新的序列表示。
多个 Head 的矩阵维度如何变化
多个 Head 虽然能够从不同的表示空间计算 Attention,但如果每个 Head 都处理完整的 维向量,计算量也会随 Head 数量快速增加。Transformer 并没有简单地复制多份完整的 Attention,而是进一步对每个 Head 的维度进行了拆分。
假设:
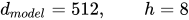
那么每个 Head 的 Query、Key 和 Value 维度通常为:
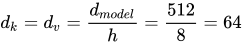
如果当前序列中有个 Token,原始输入矩阵为:

经过不同 Head 的投影以后,每个 Head 得到的 Query、Key 和 Value 都是:
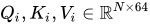
接下来在每个 Head 内部计算 Query 与 Key 的匹配关系:
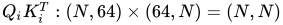
因此,无论每个 Head 的内部维度是多少,它得到的注意力权重矩阵仍然是 。这个矩阵描述的依然是序列中个位置彼此之间的匹配关系,只是不同 Head 会得到不同的权重分布。
随后,注意力权重与 Value 相乘:
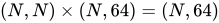
所以每个 Head 的最终输出为:
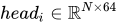
8 个 Head 各自得到一个 的结果,拼接之后重新恢复成:
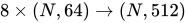
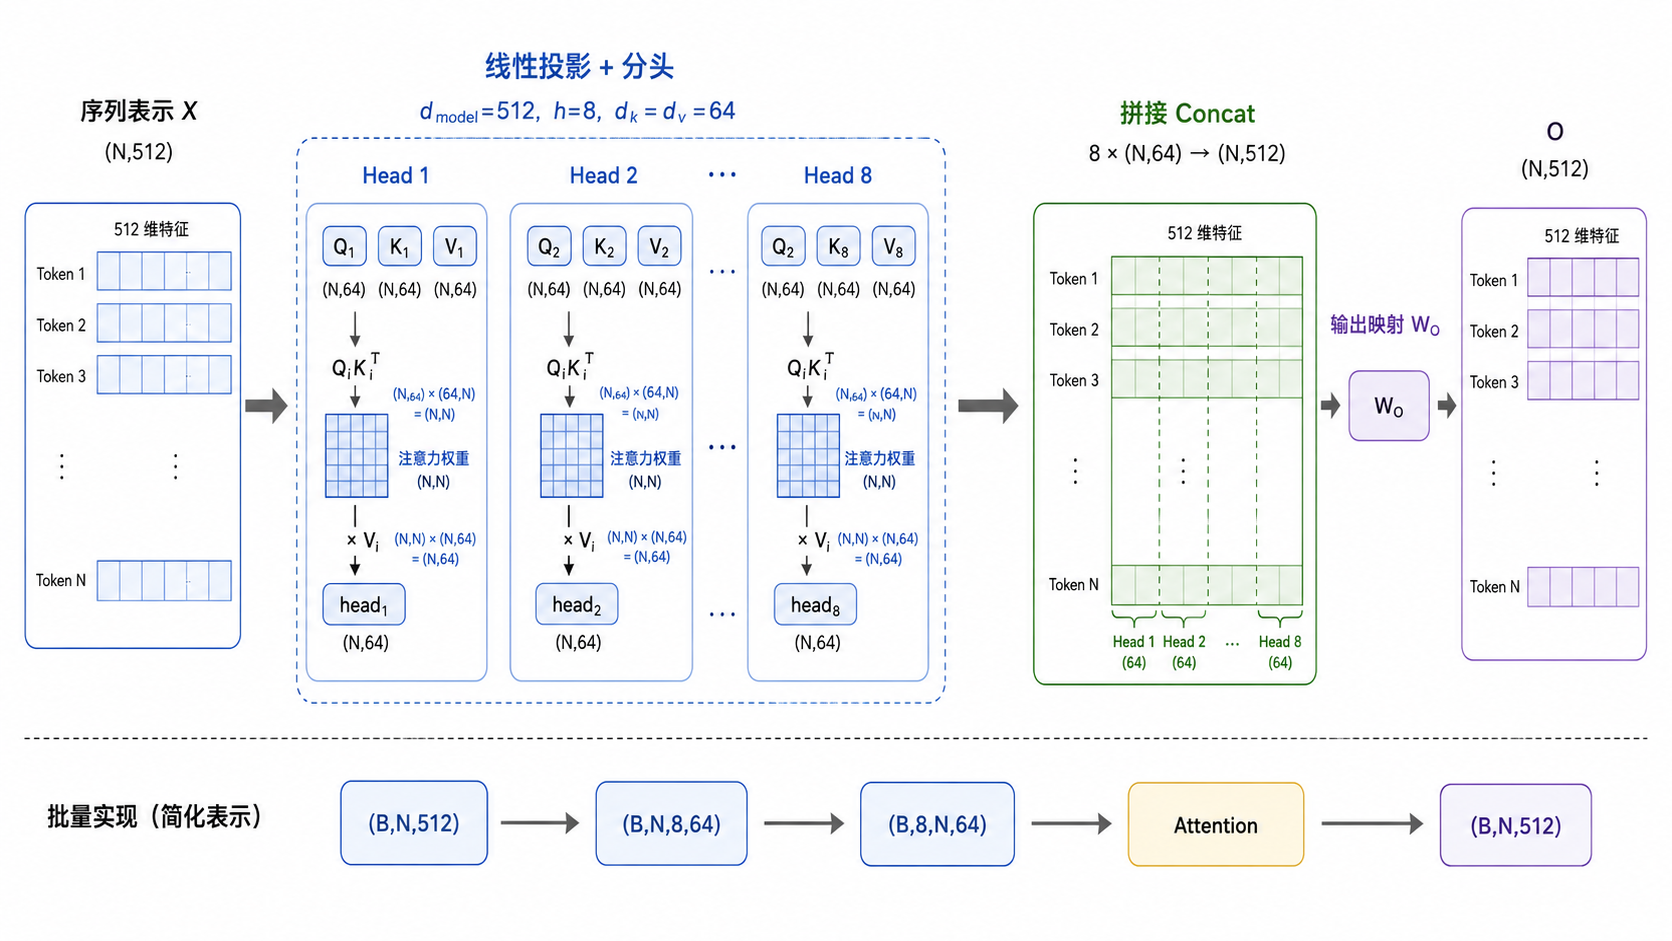
从这个过程可以看到,Multi-Head Attention 并不是让 8 个 Head 都处理完整的 512 维表示,而是把原来的表示空间划分成多个较小的子空间,让不同 Head 分别完成 Attention,最后再拼接回来。这样既可以获得多组不同的注意力关系,又不会简单地把计算规模扩大 8 倍。
代码实现时,多个 Head 并不会通过循环逐个计算,而是将 Head 作为张量中的一个维度组织起来,利用矩阵运算一次并行完成所有 Head 的 Attention 计算。
位置编码
Embedding 负责表示这是什么 Token,位置编码(Positional Encoding)负责表示这个 Token 出现在什么位置。对于序列中第个 Token,Transformer 会把它的 Token Embedding 与对应的位置编码相加:
其中,表示第个 Token,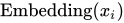 是它的语义表示,
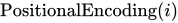 则是第个位置对应的位置表示。相加得到的
 不再只描述当前 Token 是什么,还包含了它出现在什么位置。
dog bites man
man bites dog
两次出现的dog使用同一个 Token Embedding,但由于它们所在的位置不同,需要叠加的位置编码也不同,因此最终送入模型的表示分别为:
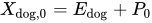
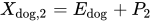
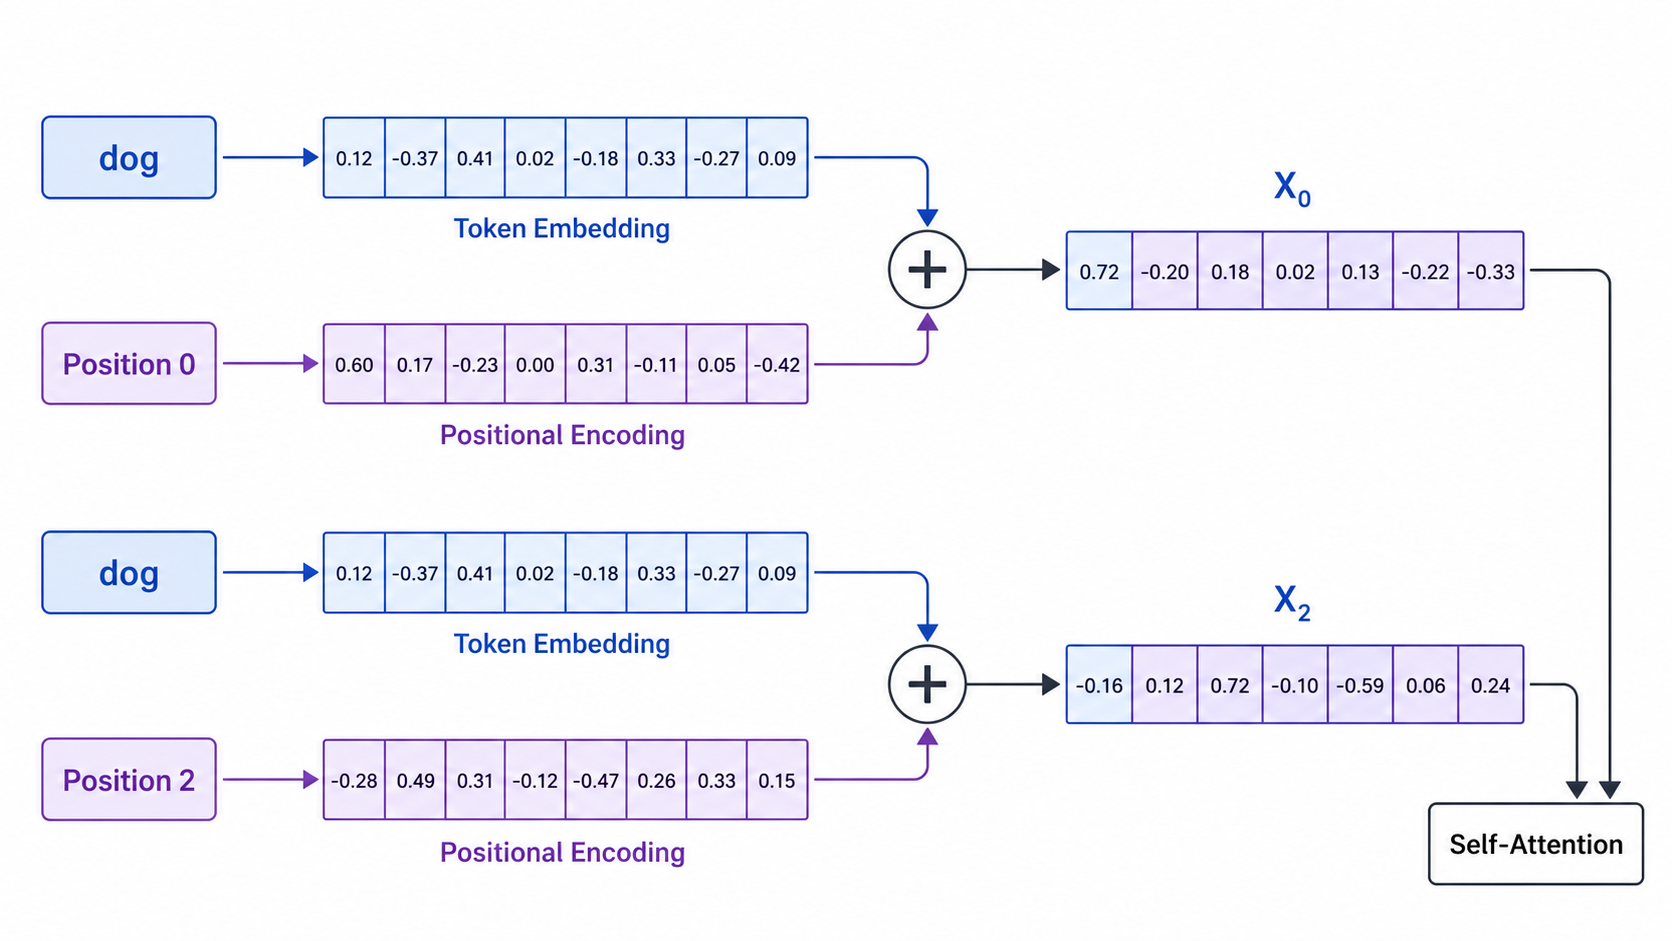
这样一来,即使 Token 本身相同,只要它出现在不同位置,最终得到的输入表示就会不同。后续由生成的 Query、Key 和 Value 也会受到位置信息影响,使 Self-Attention 在计算 Token 之间的匹配关系时,可以同时利用语义与顺序。
Transformer 论文使用正弦、余弦位置编码完成这种转换。它不需要通过训练学习,而是根据位置编号和向量维度直接计算:
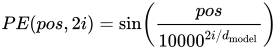
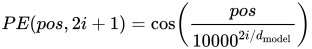
其中, 表示 Token 在序列中的位置,
 表示模型的隐藏维度。这里的不是单个维度的编号,而是正弦、余弦组合的编号。第组计算会产生两个数,并分别写入位置向量的第
 和第
 个维度:
- 第个维度使用正弦函数;
- 第个维度使用余弦函数。
也就是说,一种频率会占用位置向量中的两个维度。
如果位置编码需要 维,就使用
 组频率;如果位置编码需要
 维,就使用组频率。一般来说:
因此,如果 ,就会使用
 组不同频率,每组生成一个正弦值和一个余弦值,最终得到一个
 维的位置向量。
位置编码的维度不是由正弦和余弦函数自动决定的,而是先由确定需要多少个维度,再把这些维度两两分组,为每一组分配一种不同的频率。以 、
 为例,
- 8 个维度分成 4 组
- 分母依次是
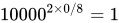 、
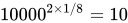 、
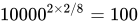 、
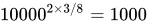
- 同一个分别代入这四组,就得到八个数:

把这八个数按维度顺序排好,最终得到的位置编码向量就是:
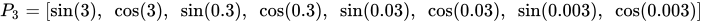
不同频率,辨别远近关系
把这些维度组合起来,每个位置就会得到一组不同的数值:
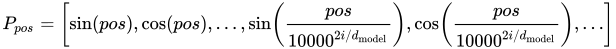
正弦和余弦内部的分母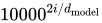 决定了这一组数值变化的速度:随着增大,分母会逐渐变大,每增加
 所带来的角度变化就会越来越小,因此不同组合会形成快慢不同的变化频率。
从单个维度观察,位置编码会随着位置变化形成一条周期曲线
- 分母小的维度每隔几个位置就转完一圈,能够区分相邻位置,但距离拉大后取值会重复;
- 分母大的维度在相邻位置上几乎看不出差别,要经过很多个位置才转完一圈,因此适合区分隔得较远的位置
快慢搭配起来,模型就可以区分距离远近不同的位置
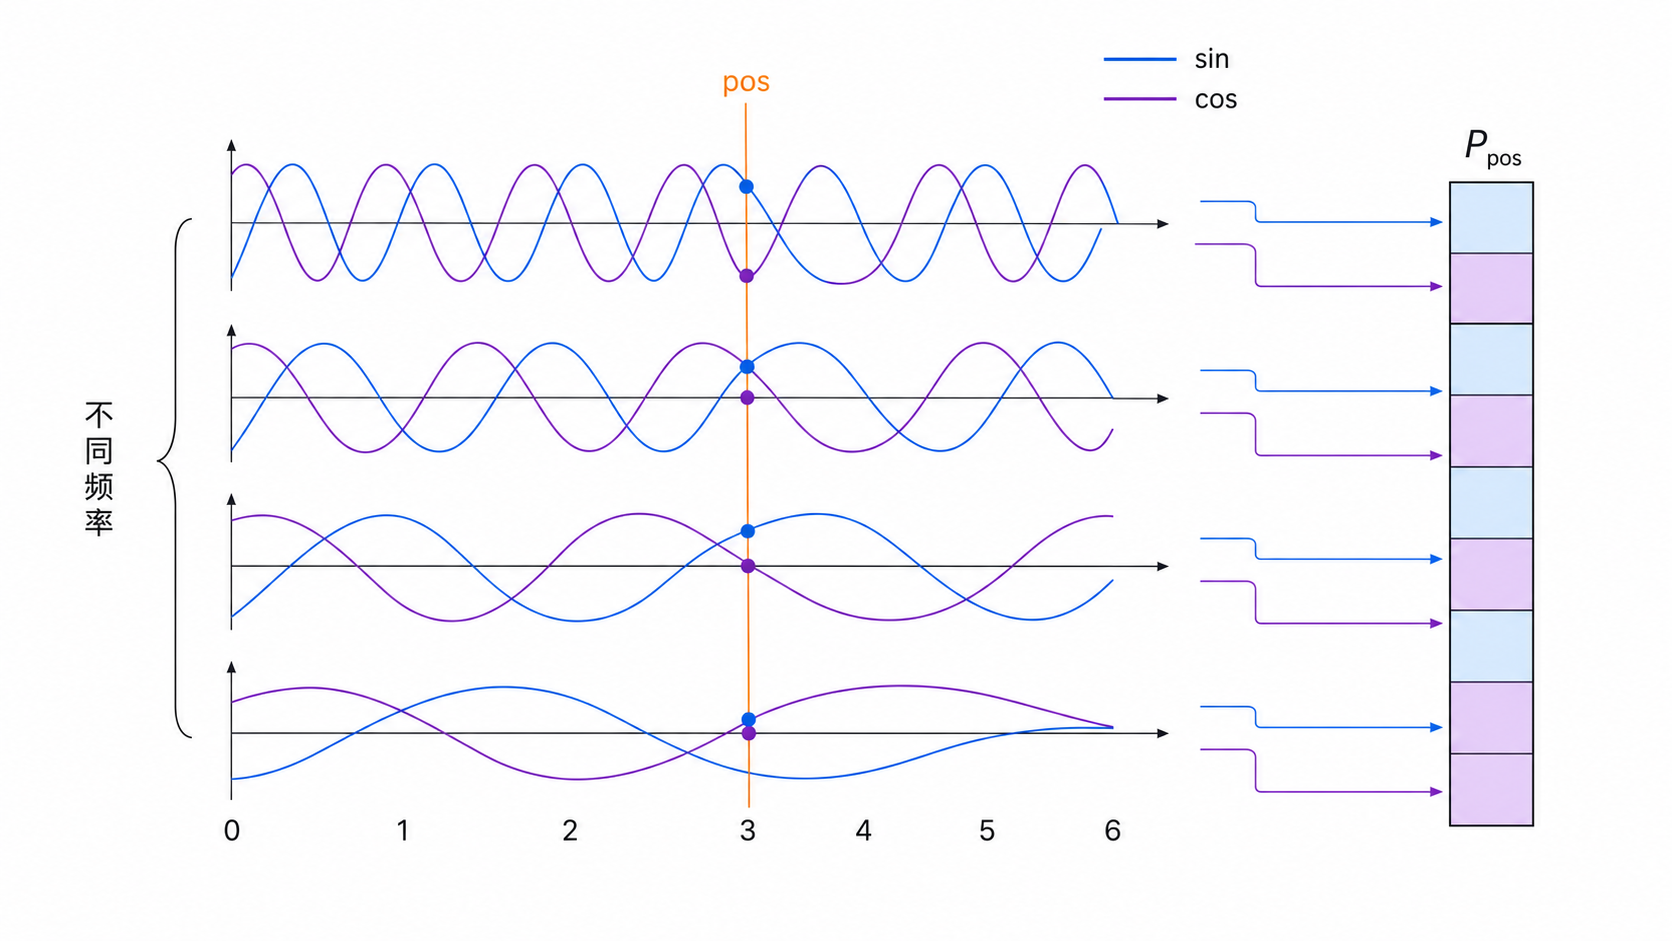
单独观察某一组正弦和余弦,它的取值会随着周期重复;但多组不同频率组合起来后,就可以为不同位置形成具有区别度的编码模式。
不同频率能够让不同位置形成不同的编码,但这还不是选择正弦和余弦的全部原因。前面提到,Attention 并不会主动拿两个位置编号做减法,它接收的是向量,然后进行线性映射和点积。既然点积一定会发生,那就看看两个位置编码点乘之后会得到什么。
把某一组的分母记作 ,这一组在位置和位置
 上各有一对正弦、余弦值。它们对应相乘再相加,正好可以合并:
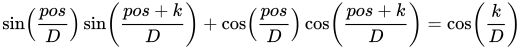
等式右边不再含有,只剩下距离 。把所有组加起来,得到的就是两个位置编码的点积:
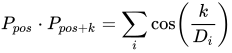
也就是说,两个位置编码的点积与它们各自处在什么绝对位置无关,只由二者相隔多远决定。
RoPE:从绝对位置到相对位置
正弦、余弦位置编码的思路是为每个 Token 添加一个位置表示,让模型知道当前 Token 位于序列中的哪个位置。它会为每个位置生成一个与 Token 表示维度相同的位置向量,然后与 Embedding 相加。
既然正弦、余弦编码的点积已经只与距离有关,为什么还会出现新的方案?因为这个性质是对位置编码本身成立的。位置编码是加在输入上的,真正进入注意力分数的是 经过
 、
 投影之后的结果,展开后既包含语义与语义的项,也包含语义与位置的交叉项,只依赖距离的结构不再被保证,能不能用上相对位置,要交给训练过程自己去学。
而很多语言理解任务关注的并不是某个词位于第几个位置,而是两个词之间的距离和顺序关系。例如,dog是否位于bites之前,当前 Token 与相关信息相隔多远,这些相对位置关系往往更加重要。
旋转位置编码(Rotary Position Embedding,RoPE)采用了不同的思路,它不再生成一个额外的位置向量,而是利用 Token 的位置信息,对 Attention 中的 Query 和 Key 向量进行旋转。
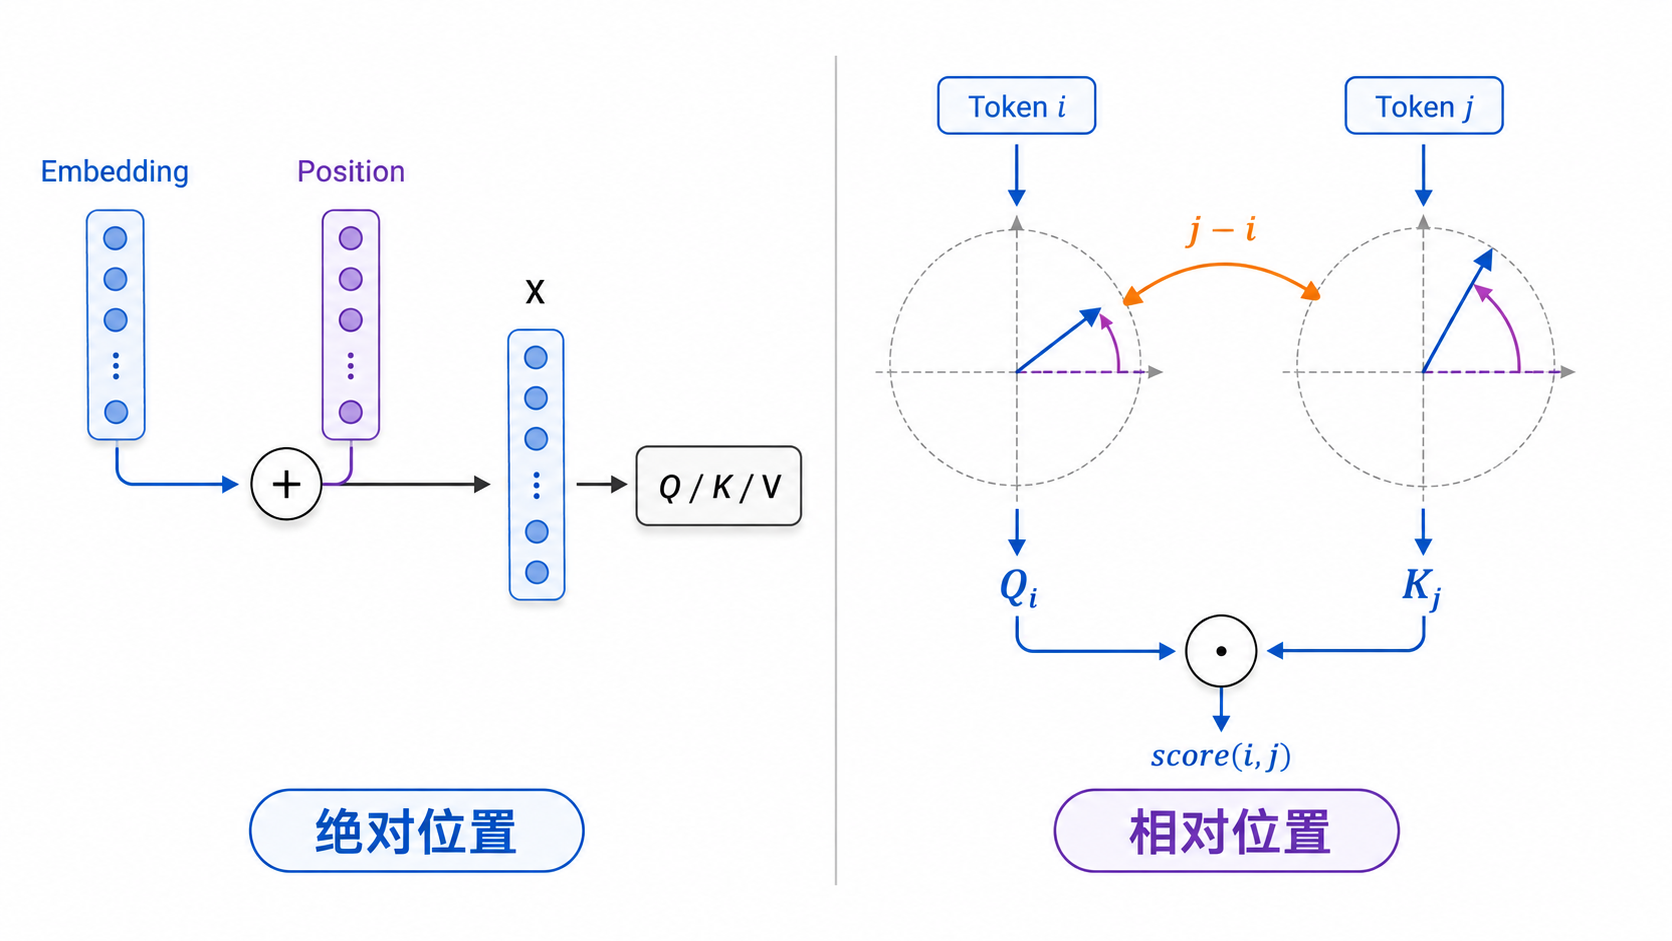
假设某个 Token 经过线性变换后得到 Query:
q=[q_1,q_2,q_3,q_4,…]
RoPE 会将相邻两个维度组合成二维向量,例如:
(q_1,q_2),(q_3,q_4),…
然后根据该 Token 所处的位置m,为每组二维向量计算一个旋转角度,并使用旋转矩阵改变向量方向:
\begin{bmatrix} q_1’\\ q_2′ \end{bmatrix} = \begin{bmatrix} \cos\theta_m & -\sin\theta_m\\ \sin\theta_m & \cos\theta_m \end{bmatrix} \begin{bmatrix} q_1\\ q_2 \end{bmatrix}
其中\theta_m由 Token 的位置决定。位置越靠后,旋转角度越大;不同维度使用不同的旋转频率,因此可以同时捕捉不同距离范围的位置关系。
Key 也进行同样的旋转。由于旋转发生在W_Q、W_K投影之后,Query 与 Key 做点积时,两边共同的绝对旋转会相互抵消,分数中只剩下与位置差n-m有关的相对角度。
这也是 RoPE 与把位置加在输入上的做法的关键区别,后者的相对性只存在于编码层面,能否保留到分数里取决于训练;而 RoPE 不管语义向量是什么,相对距离都必然出现在注意力分数中。
Attention 最终关注的是 Query 和 Key 之间的匹配关系,而语言中的很多信息也依赖 Token 之间的相对距离和顺序。RoPE 让这种相对位置关系自然体现在注意力分数中,使模型能够更直接地理解不同 Token 之间的位置关系,同时保持原有向量维度,不增加额外参数。目前主流大语言模型普遍采用 RoPE 作为位置编码方案。