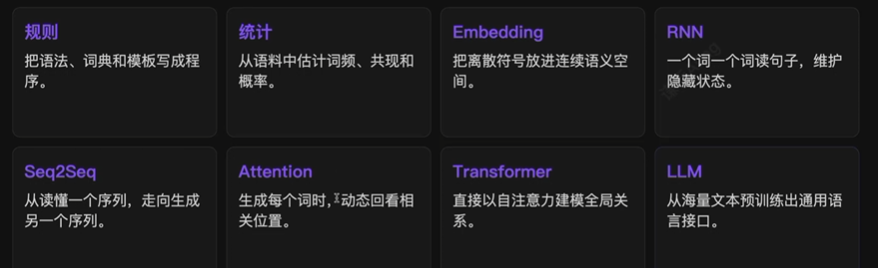
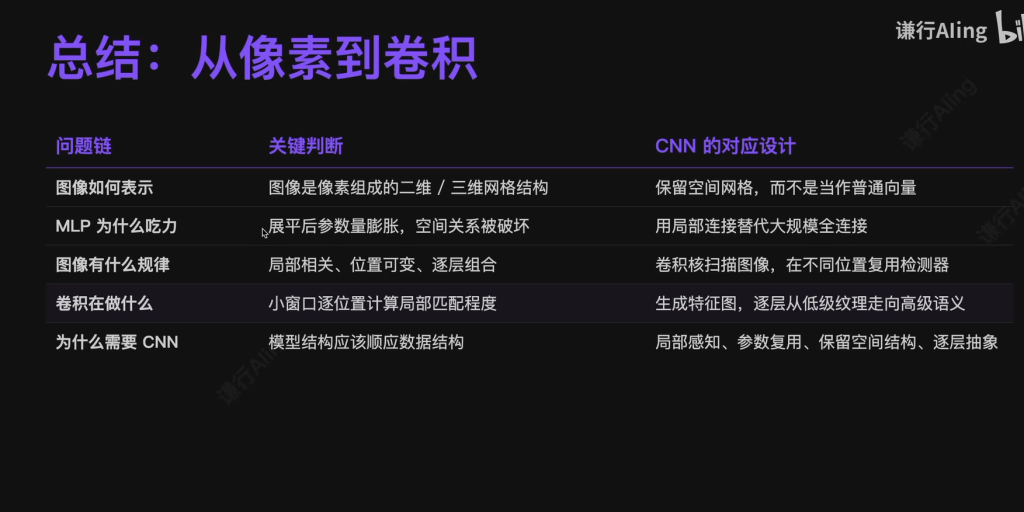
一.解决问题:
文本模型不仅要知道有哪些词,还要利用词序和上下文
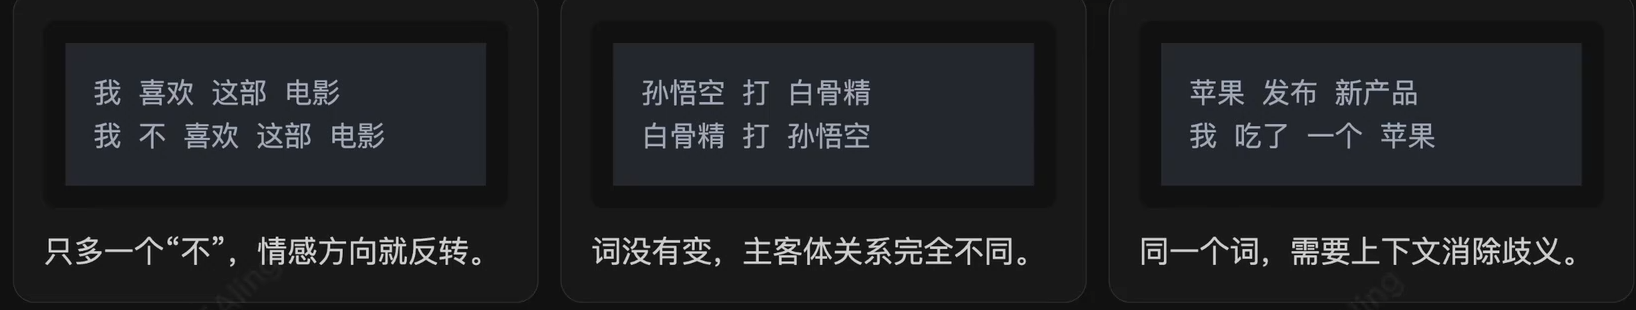
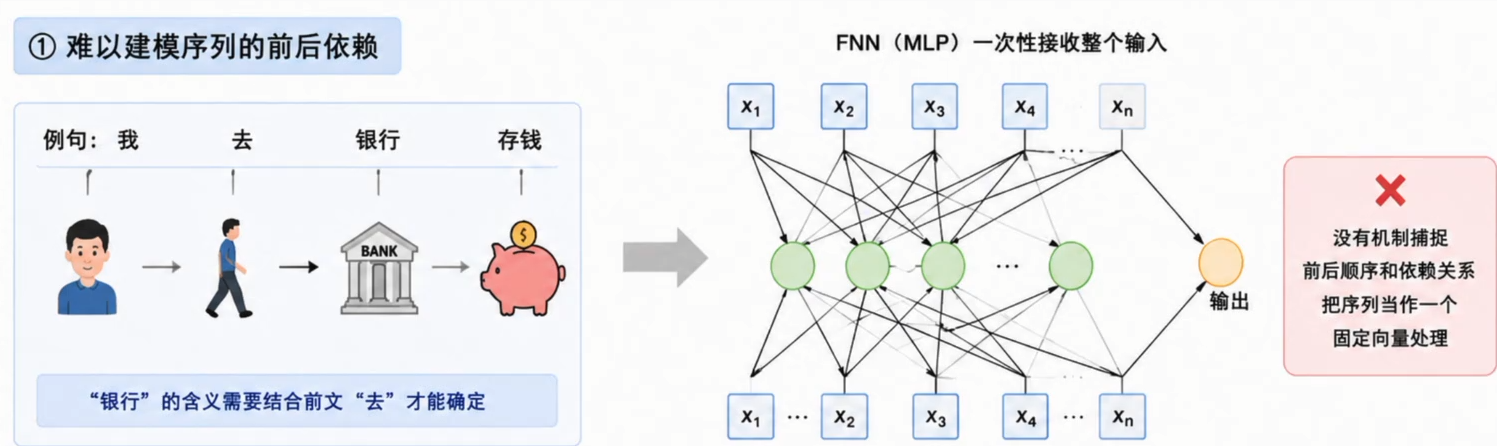
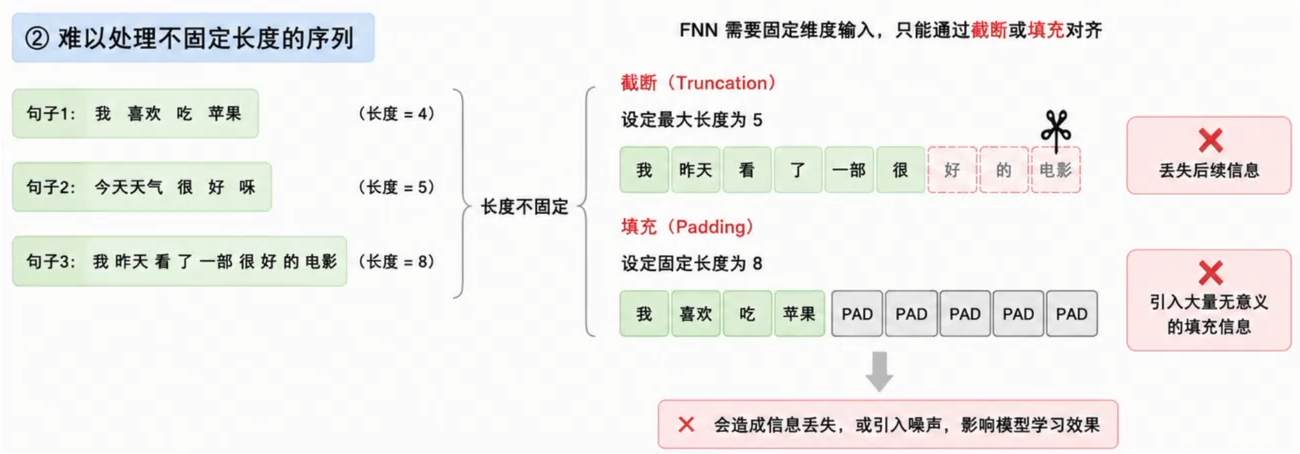
为什么前馈神经网络不适合处理自然语言序列:
fnn是一种信息单向传播的网络:数据从输入层出发,依次通过隐藏层到达输出层,网络内部没有循环连接.mlp就是经典的fnn
1.前后依赖:一次性处理整段输入,没有沿时间建模上下文的机制
2.变长序列:输入维度必须先固定,长短不一的句子很难对齐.
二.rnn的解决思路:改变读取方式
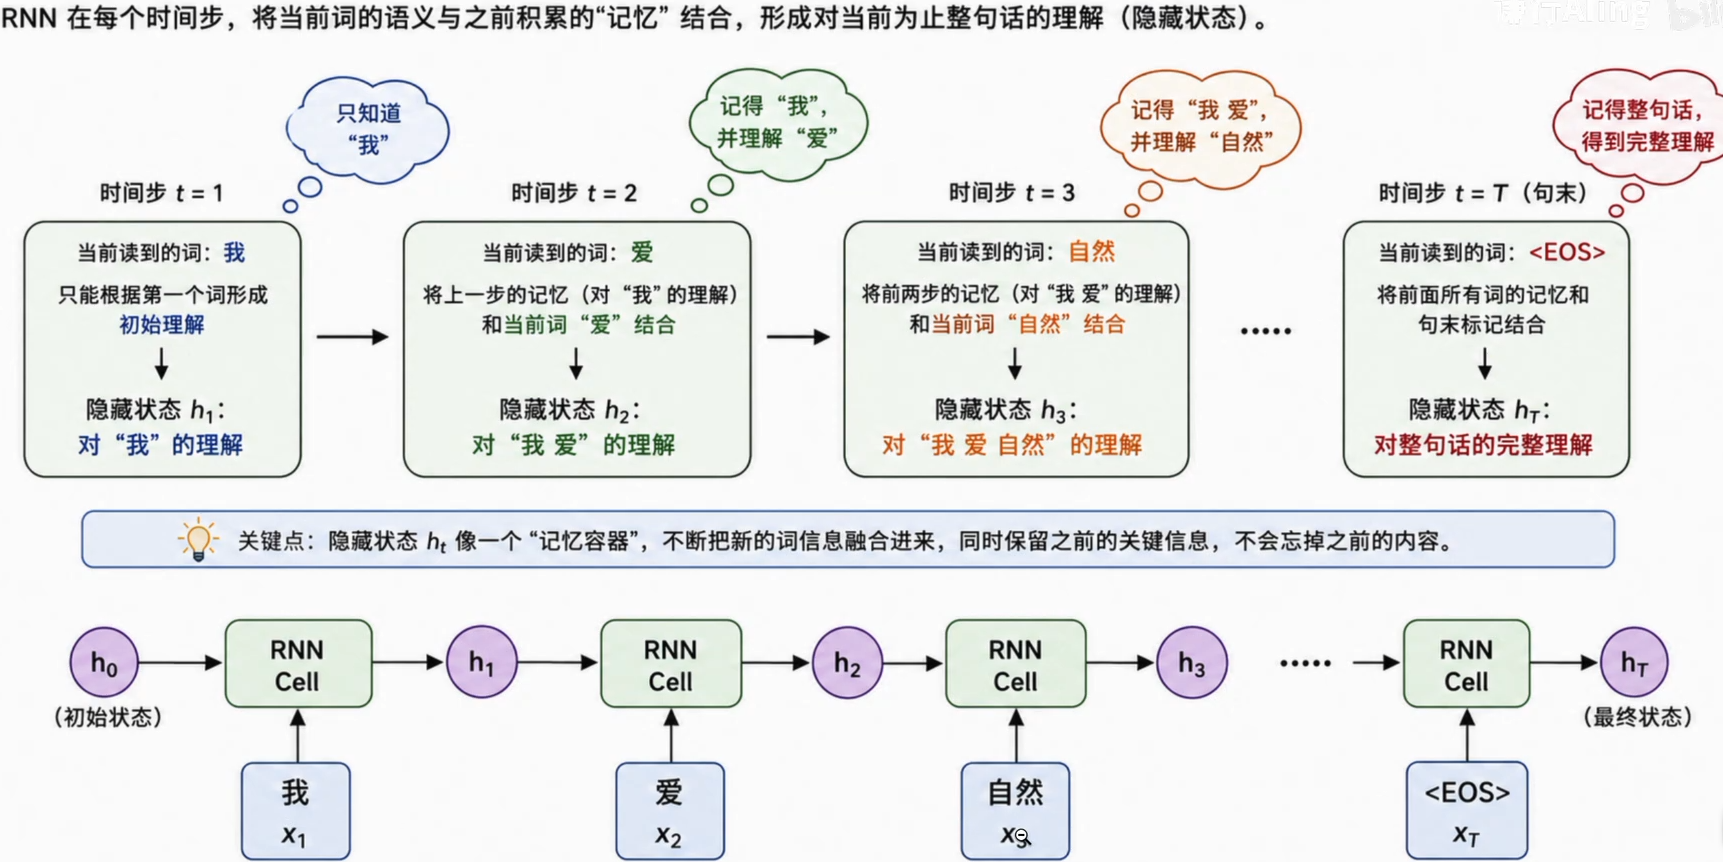
rnn不会把整个句子拼成固定向量,而是从左到右逐个读取token.
1.读第一个词,只能根据当前输入形成初始状态
2.读第二个词,把新词与上一步留下的状态结合
3.读第三个词,前两步累积的信息继续参与计算
4,重复这个过程直到整个序列处理完毕
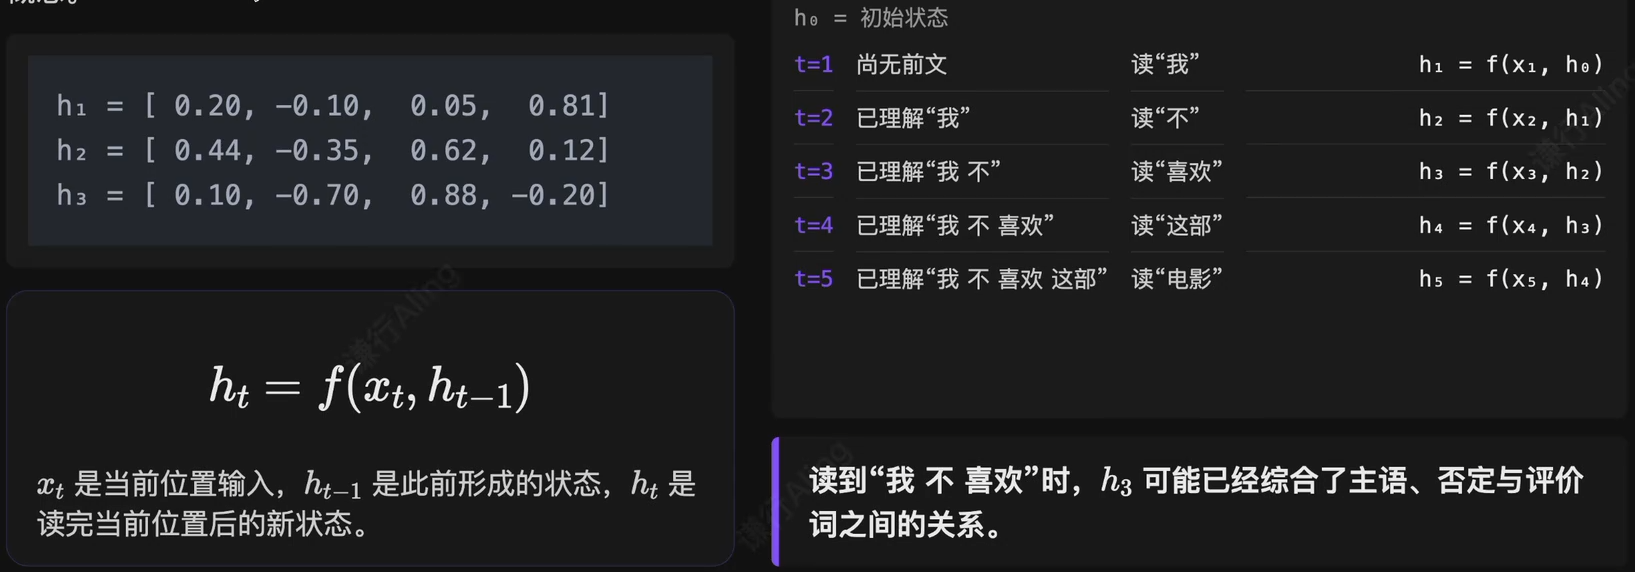
隐藏状态:是前文的压缩摘要
本质是一个向量,信息由多个维度共同表达
RNN layer
本质:同一个cell沿序列循环调用
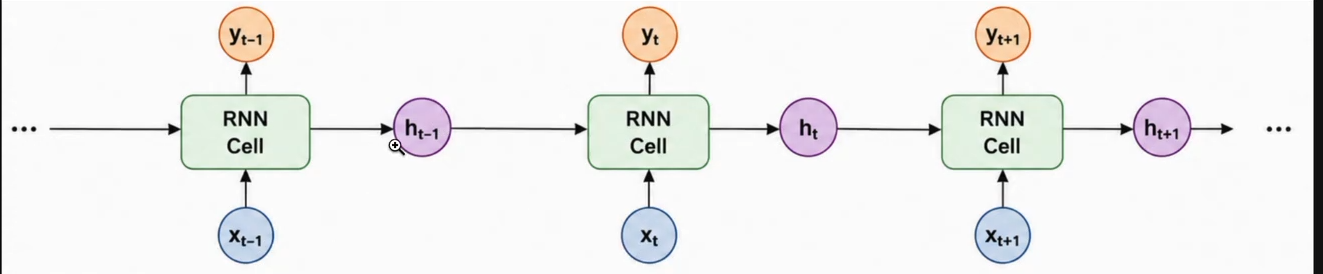
任务头放在循环内,就会每步输出;放在循环外,就只读最后状态
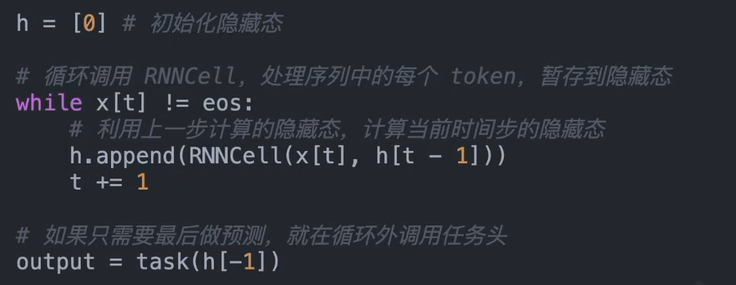
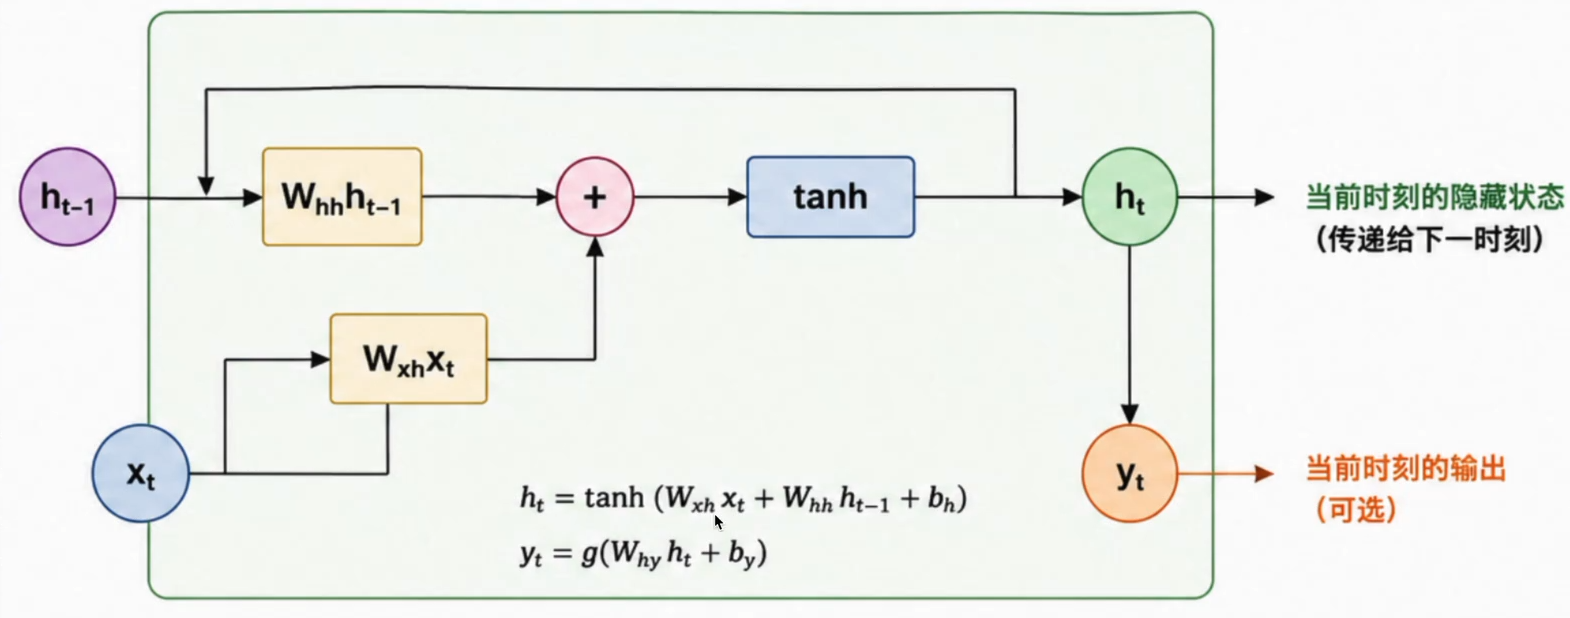
一个cell中的流程
RNNCell(Xt,Ht-1)–>Ht
Xt:当前token中的词向量,是当前时间步的新信息;Ht-1:当前已经积累的上下文
参数共享的优点:
RNN:每一步复用同一个f
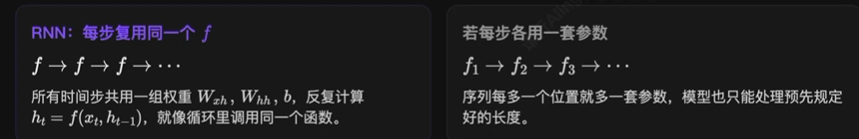
好处:1.参数量与句长解耦:句子变长只用多循环,参数规模保持不变
2.一套规则通吃任意长度:都使用一套规则逐步处理
参数共享使RNN真正获得处理不定长序列的能力
RNN类型
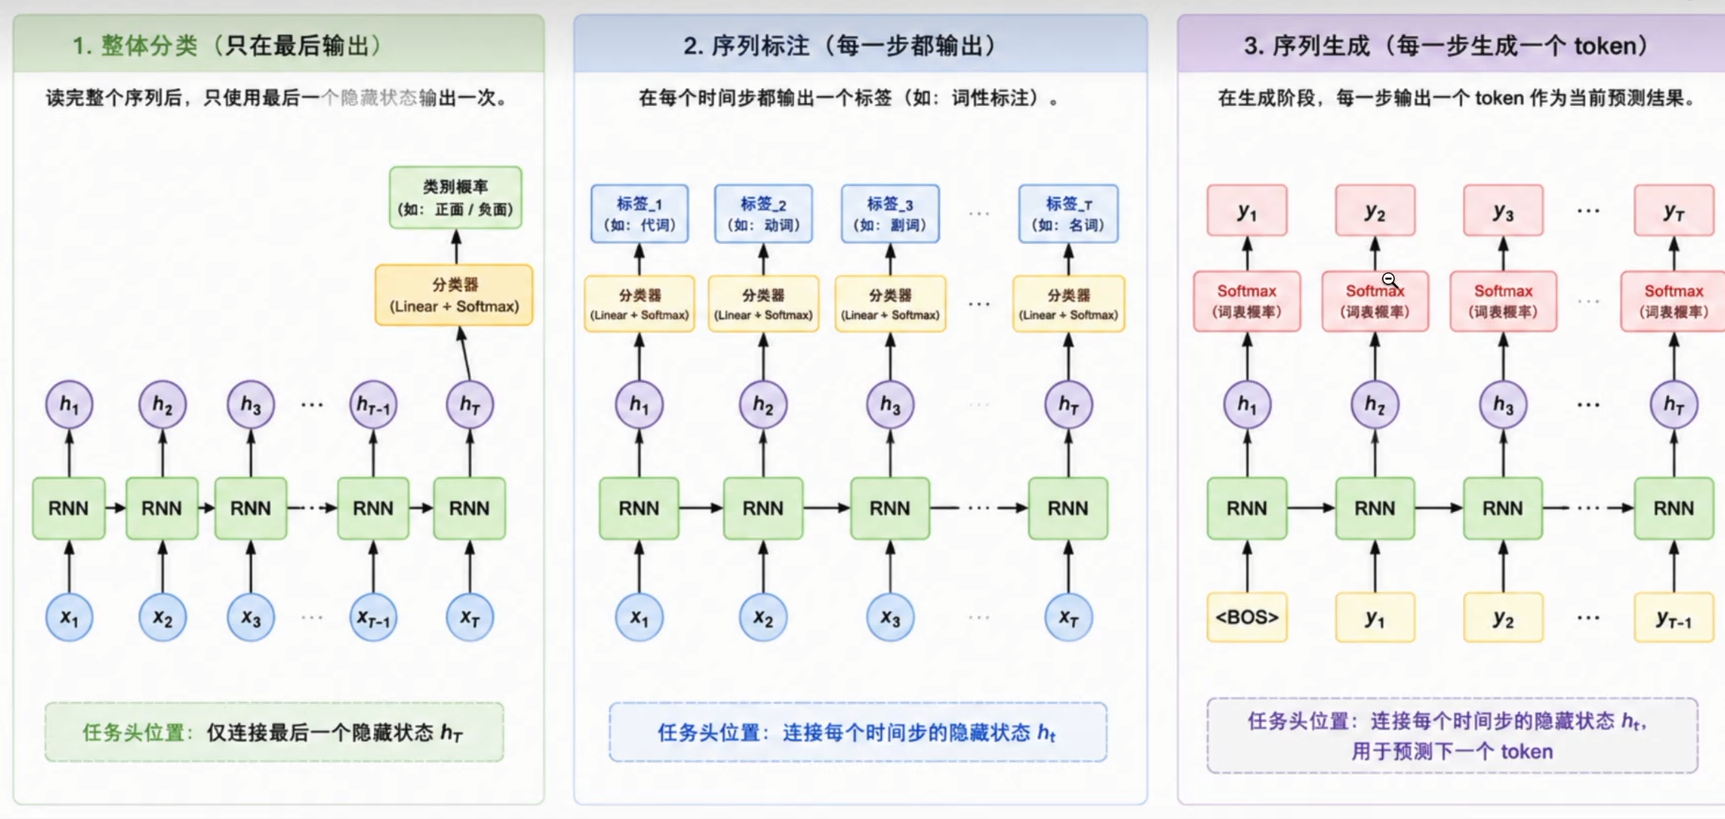
1.整体分类:输入一整段序列,输出一个整体标签
应用:情感分类,垃圾邮件识别,新闻分类
核心:读完整段序列,只取最后状态交给分类器,输出一个整体标签
import torch
import torch.nn as nn
class RNNClassifier(nn.Module):
def __init__(self, vocab_size, embed_dim, hidden_dim, num_classes):
super().__init__()
# token id -> 词向量
self.embedding = nn.Embedding(vocab_size, embed_dim)
# 沿序列更新状态
self.rnn = nn.RNN(embed_dim, hidden_dim, batch_first=True)
# 状态 -> 类别分数
self.classifier = nn.Linear(hidden_dim, num_classes)
def forward(self, token_ids):
# token_ids: [batch, seq_len]
x = self.embedding(token_ids) # [batch, seq_len, embed_dim]
# states: 每步状态; h_n: 最后一步状态
states, h_n = self.rnn(x)
# 只取最后状态 [batch, hidden_dim]
h_last = h_n[-1]
# 整段 -> 一个标签 [batch, num_classes]
logits = self.classifier(h_last)
return logits
2.序列标注:每个位置都输出标签
应用:词性标注,命名实体识别
核心:每个时间步的状态都过同一个分类器,逐位置输出标签`
import torch
import torch.nn as nn
class RNNLanguageModel(nn.Module):
def __init__(self, vocab_size, embed_dim, hidden_dim):
super().__init__()
self.embedding = nn.Embedding(vocab_size, embed_dim)
self.rnn = nn.RNN(embed_dim, hidden_dim, batch_first=True)
self.lm_head = nn.Linear(hidden_dim, vocab_size)
def forward(self, token_ids):
x = self.embedding(token_ids) # [batch, seq_len, embed_dim]
states, h_n = self.rnn(x) # 保留每个时间步的状态
logits = self.lm_head(states) # 每个位置预测下一词 [batch, seq_len, vocab_size]
return logits
3.序列生成:每个位置预测下一个token
核心:与序列标注同构,但输出维度换成词表大小,每个位置都预测下一个token
import torch
import torch.nn as nn
class RNNLanguageModel(nn.Module):
def __init__(self, vocab_size, embed_dim, hidden_dim):
super().__init__()
self.embedding = nn.Embedding(vocab_size, embed_dim)
self.rnn = nn.RNN(embed_dim, hidden_dim, batch_first=True)
self.lm_head = nn.Linear(hidden_dim, vocab_size)
def forward(self, token_ids):
x = self.embedding(token_ids) # [batch, seq_len, embed_dim]
states, h_n = self.rnn(x) # 保留每个时间步的状态
logits = self.lm_head(states) # 每个位置预测下一词 [batch, seq_len, vocab_size]
return logits
三类任务输出方式不同,训练流程是一致的:
沿序列前向–>任务头输出–>计算有效位置损失–>沿状态链反向传播
梯度回传路径:损失从输出–>任务头–>隐藏状态链–>Embedding
所有任务动员归结于一类:把梯度沿时间链传回共享的参数
序列生成实列
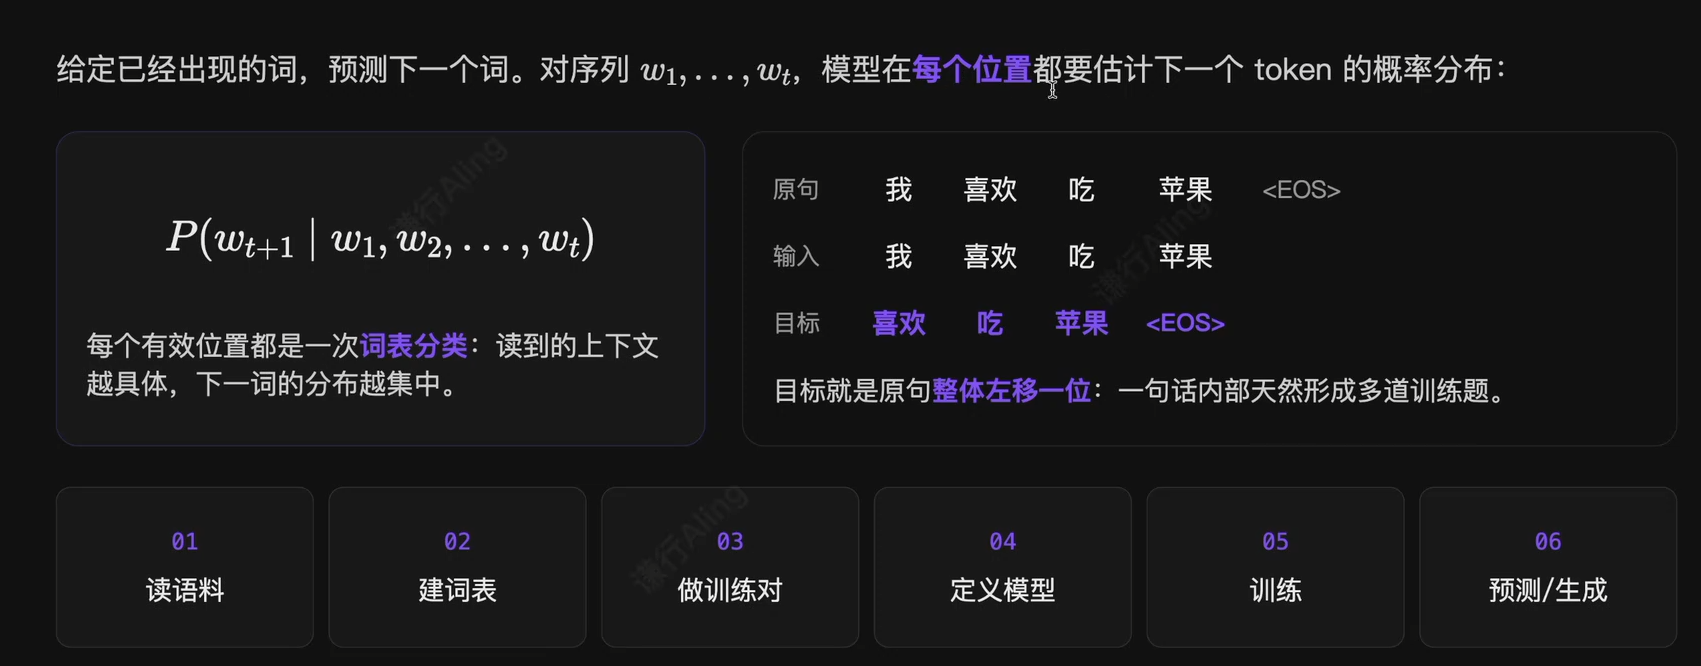
1.准备预料与训练对
import random
from pathlib import Path
import torch
import torch.nn as nn
from torch.nn.utils.rnn import pad_sequence # 把变长序列补齐成同一长度
# ---------- 1) 读取语料 ----------
# 语料每行一句话,词与词之间已用空格分好
lines = corpus_path.read_text(encoding="utf-8").splitlines()
# 丢掉空行,再按空格切成 token 列表: ["我", "喜欢", ...]
sentences = [s.split() for s in lines if s.strip()]
# ---------- 2) 建立词表 ----------
# 三个特殊 token 固定放在最前,保证它们的 id 稳定
PAD, UNK, EOS = "<PAD>", "<UNK>", "<EOS>" # 补齐 / 未知词 / 句子结束
# 其余词去重后排序,接在特殊 token 之后组成词表
vocab = [PAD, UNK, EOS] + sorted(
{w for s in sentences for w in s}) # 词 → 整数 id
word_to_id = {w: i for i, w in enumerate(vocab)}
# id → 词 (预测时反查)
id_to_word = {i: w for w, i in word_to_id.items()}
# 记下 <PAD> 的 id
pad_id = word_to_id[PAD]
# ---------- 3) 制作训练对 ----------
# 每句话末尾补一个 <EOS>,让模型学会"何时停下"
encoded = [torch.tensor(
[word_to_id[w] for w in s] + [word_to_id[EOS]])
for s in sentences]
# 输入去掉最后一个词、目标去掉第一个词 → 两者天然错开一位
# 例: 输入「我 喜欢 吃 苹果」/ 目标「喜欢 吃 苹果 <EOS>」
inputs = pad_sequence([e[:-1] for e in encoded],
batch_first=True, padding_value=pad_id) # 同一 batch 内短句用 <PAD>
targets = pad_sequence([e[1:] for e in encoded],
batch_first=True, padding_value=pad_id)
2.定义模型:embedding+rnn+linear
核心:把embedding+rnn+linear串起来:token序列–>词向量–>每步隐藏状态–>每步词表分数
import torch
import torch.nn as nn
class NextWordRNN(nn.Module):
def __init__(self, vocab_size, embed_dim=48, hidden_dim=96, pad_id=0):
super().__init__()
# 词嵌入层: token id -> embed_dim 维词向量
# padding_idx=pad_id 让 <PAD> 的向量恒为零,且不参与更新
self.embedding = nn.Embedding(vocab_size, embed_dim, padding_idx=pad_id)
# RNN 层: 沿序列逐步更新隐藏状态
# batch_first=True -> 输入形状为 [batch, seq_len, embed_dim]
self.rnn = nn.RNN(embed_dim, hidden_dim, batch_first=True)
# 输出层: 把每一步的隐藏状态映射成词表上的分数 logits
self.output = nn.Linear(hidden_dim, vocab_size)
def forward(self, token_ids):
# token_ids: [batch, seq_len]
embeddings = self.embedding(token_ids) # [batch, seq_len, embed_dim]
states, _ = self.rnn(embeddings) # [batch, seq_len, hidden_dim]
return self.output(states) # [batch, seq_len, vocab_size]
3.训练
核心:把每个位置当成一道分类题,用交叉熵反复前向反向更新参数
import torch
import torch.nn as nn
# 交叉熵损失; ignore_index=pad_id 让补齐位置不计入损失
criterion = nn.CrossEntropyLoss(ignore_index=pad_id)
# Adam 优化器,学习率 0.01
optimizer = torch.optim.Adam(
model.parameters(), lr=0.01)
for epoch in range(1, 10001):
logits = model(inputs) # 前向: [B, T, V] = [batch, seq_len, vocab_size]
# 把 logits 摊平成 [B*T, V]、目标摊平成 [B*T]
# 于是每个时间步都成为一道独立的“下一词分类题”
loss = criterion(
logits.reshape(-1, len(vocab)),
targets.reshape(-1))
optimizer.zero_grad() # 清空上一轮累积的梯度
loss.backward() # 反向传播: 梯度沿时间链反向传播
optimizer.step() # 按梯度更新参数
4.预测与生成:
核心:只看最后一步的分布,softmax后取top-k,反复取top-1追加回序列
import torch
@torch.no_grad() # 预测阶段不需要计算梯度
def predict_next(prefix, top_k=5):
# 把前缀里的词转成 id,不在词表里的词用 <UNK> 兜底
ids = [word_to_id.get(w, word_to_id[UNK])
for w in prefix.split()]
# 前向后只取“最后一个时间步”的输出 = 紧接前缀的下一词分布
logits = model(torch.tensor([ids]))[0, -1].clone()
logits[pad_id] = -torch.inf # 不允许生成 <PAD>
logits[word_to_id[UNK]] = -torch.inf # 不允许生成 <UNK>
probs = torch.softmax(logits, dim=-1) # 分数 logits 转概率
v, i = torch.topk(probs, top_k) # 取概率最高的 top_k
return [(id_to_word[j.item()], p.item())
for p, j in zip(v, i)]
def generate(prefix, max_new_words=8): # 贪心生成:每次取概率最高的词
words = prefix.split()
for _ in range(max_new_words):
# 取当前概率最高的词,追加到末尾,再用新序列继续预测
nxt, _ = predict_next(" ".join(words), 1)[0]
if nxt == EOS: break # 生成到 <EOS> 停止
words.append(nxt)
return " ".join(words)
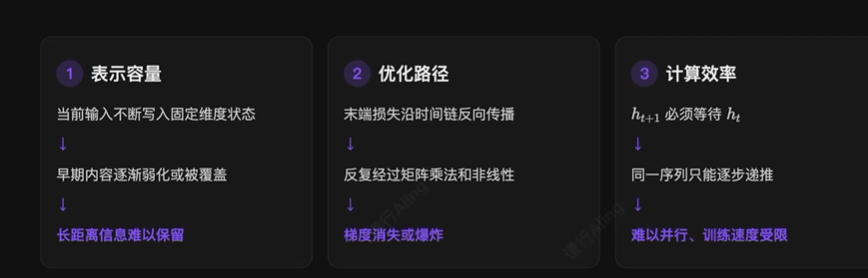
RNN的局限:
不管序列多长,rnn每一步都要把当前输入和全部过去重新压缩进同一个固定维度的隐藏状态里
序列变长后,早期信息更容易被后续输入覆盖
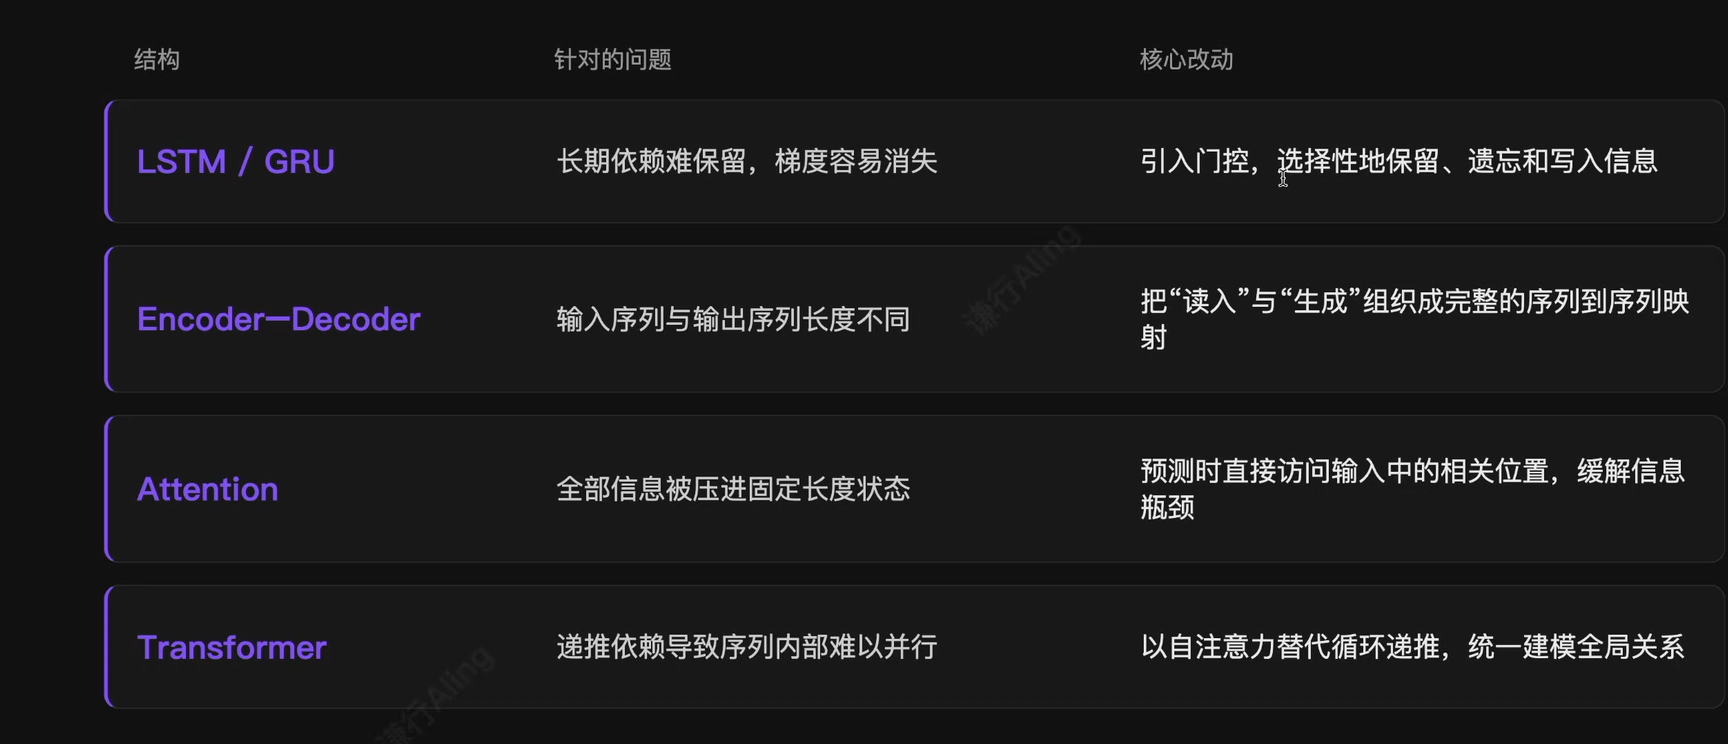
替代方案:
rnn缺点演示:
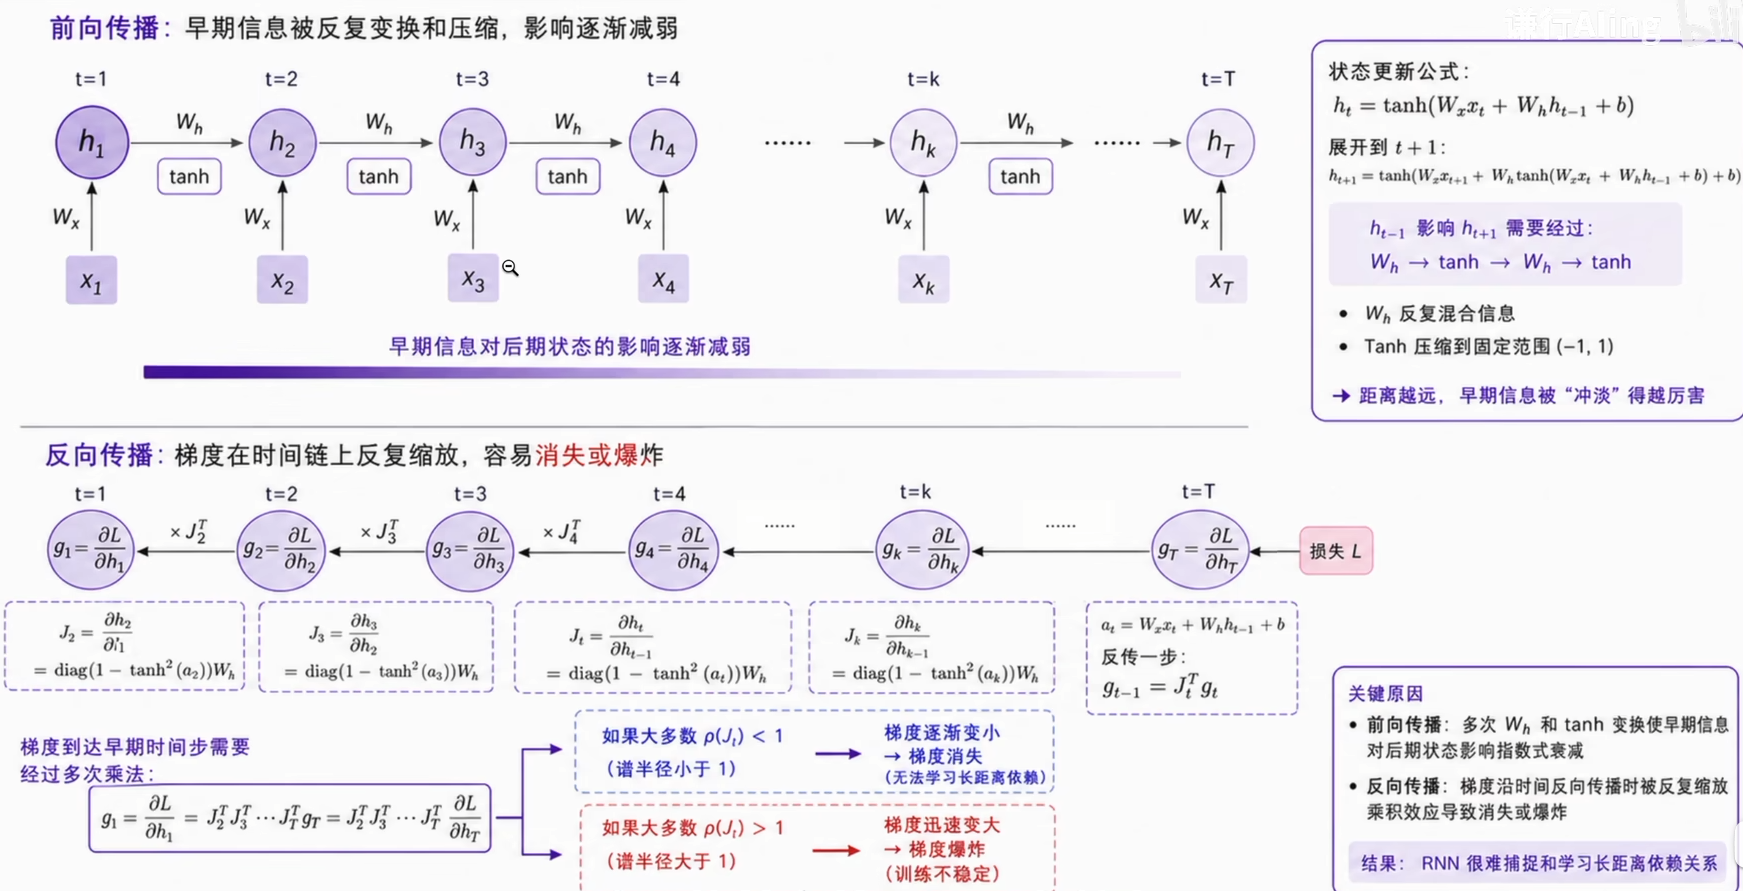
距离每增加一步,状态就多经历一次重写
同一条时间链,同时限制信息与梯度:早期信息逐渐减弱;训练信号被反复缩放
lstm
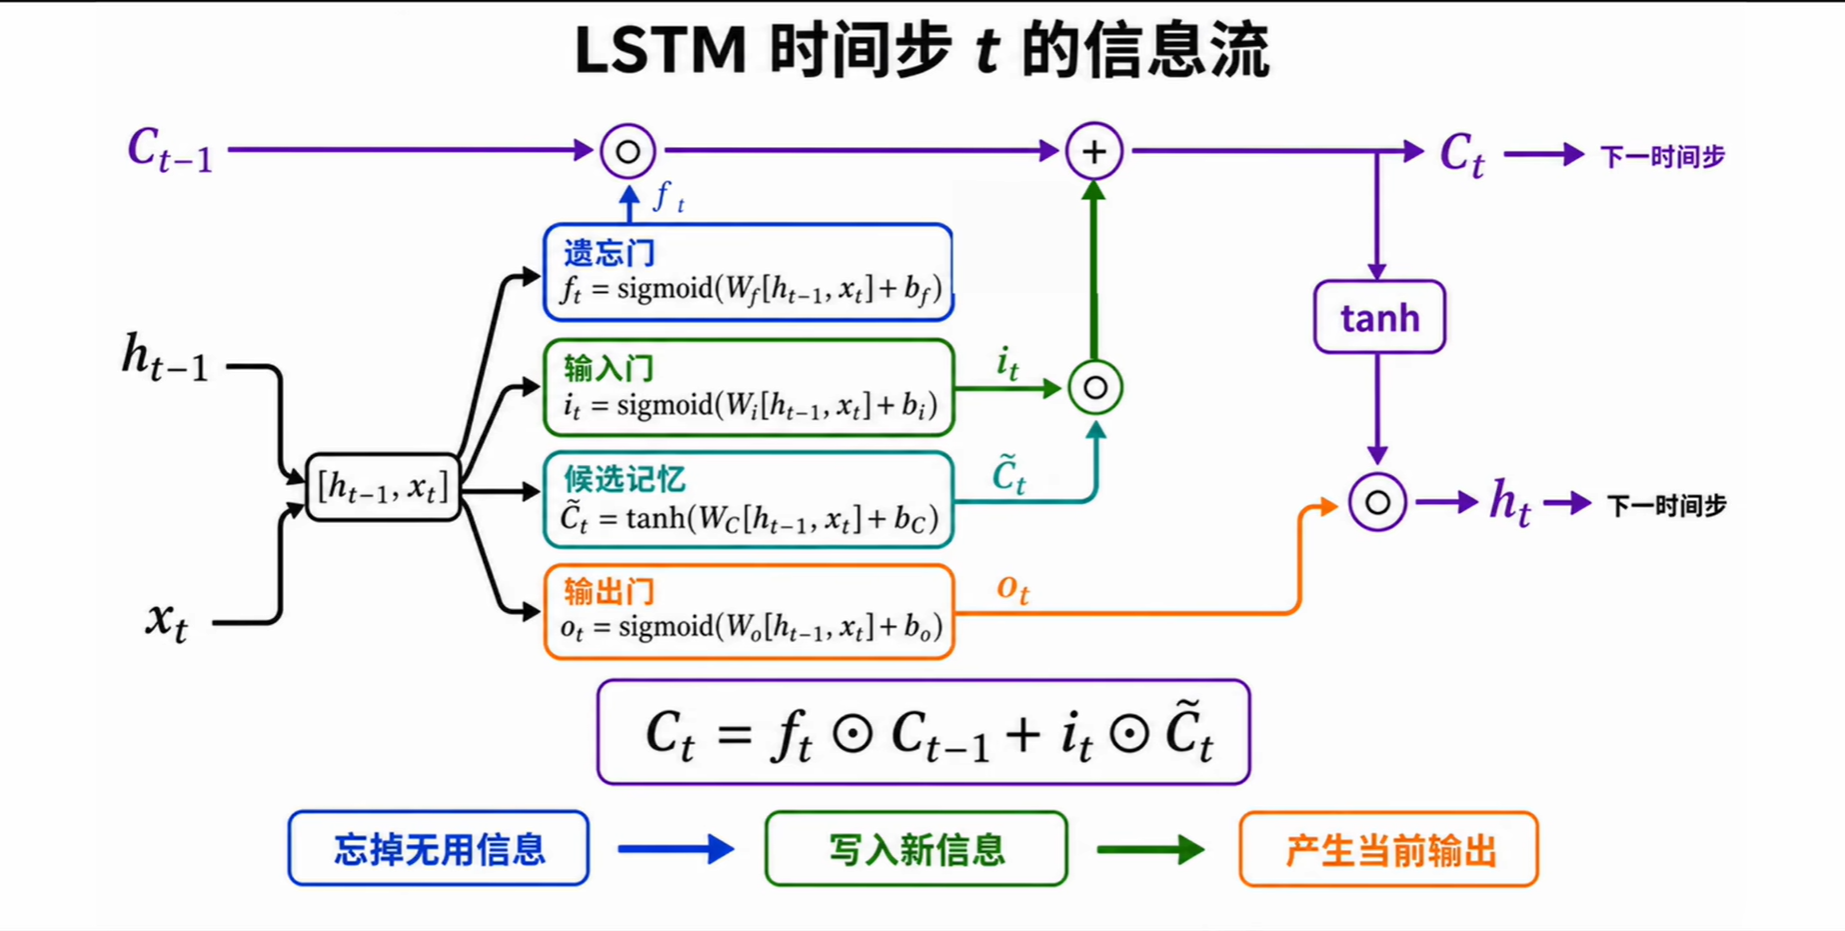
遗忘门决定旧记忆保留多少
遗忘门(forget gate)读取当前输入 与上一步隐藏状态
 ,计算遗忘门值

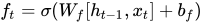
其中 表示向量拼接,
 和
 是遗忘门的参数。遗忘门不会直接生成新内容,只负责控制旧细胞状态
 有多少可以继续进入当前状态。

 表示逐元素乘法,如果某些维度的接近 1,对应的旧信息会被保留;如果接近 0,对应信息会被快速清除。与普通 RNN 对全部状态统一重写相比,LSTM 开始具备逐维度保留历史信息的能力。
输入门决定新记忆写入多少
只会忘记还不够,模型还需要决定当前输入中的哪些内容值得写入长期状态。LSTM 先生成一份候选记忆
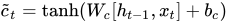
候选记忆 包含当前时间步可能写入的新内容。随后,输入门(input gate)计算每一维的写入比例
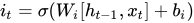
真正写入状态的内容是

输入门与候选记忆分工明确,候选记忆回答当前可以写入什么,输入门回答这些内容实际写入多少。两者结合以后,LSTM 才能避免每个新 token 都大幅改变长期状态。
细胞状态用加法完成更新
保留下来的旧记忆与筛选后的新记忆相加,形成当前细胞状态
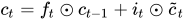
这个公式是 LSTM 最重要的结构,RNN 用一个非线性函数整体生成 ,LSTM 则把状态更新拆成两部分,一部分沿旧状态继续传递,另一部分作为新内容加入。
输出门决定当前暴露哪些记忆
细胞状态保存了长期信息,但当前时间步不一定需要把其中所有内容都交给任务头或下一个时间步。输出门(output gate)负责控制当前状态对外暴露多少
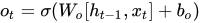
最终隐藏状态为
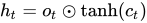
Tanh 把细胞状态压缩到 ,输出门再逐维筛选,得到当前隐藏状态。因此,某份信息可以继续保存在
 中,却暂时不出现在里;等后面上下文需要它时,再通过输出门重新参与预测。
把 LSTM 的一次完整更新放在一起,可以写成
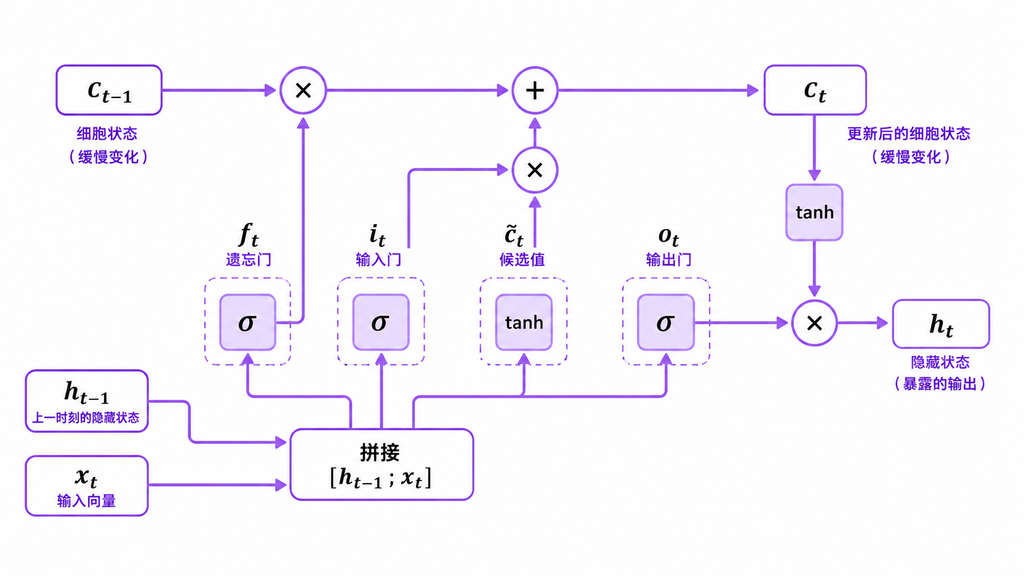
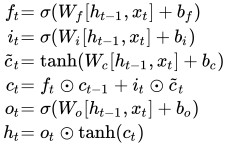
三道门和候选记忆各有自己的参数,但它们每个时间步仍然共享使用。LSTM 没有改变 RNN 按顺序递推的基本框架,它改变的是每一步如何更新状态。
GRU 工作流程
GRU 在第 个时间步接收当前输入和上一步隐藏状态。它先根据这两个向量计算重置门
 与更新门
 ,再分两步完成状态更新。
第一步是准备一份候选状态。重置门先筛选中哪些历史信息需要参与候选状态的计算,再把筛选后的历史与结合,得到可能写入的新内容 。第二步才是真正更新状态,更新门在旧状态和候选状态之间分配比例,得到最终的。
重置门决定生成新内容时参考多少过去,更新门决定生成的新内容最终写入多少。
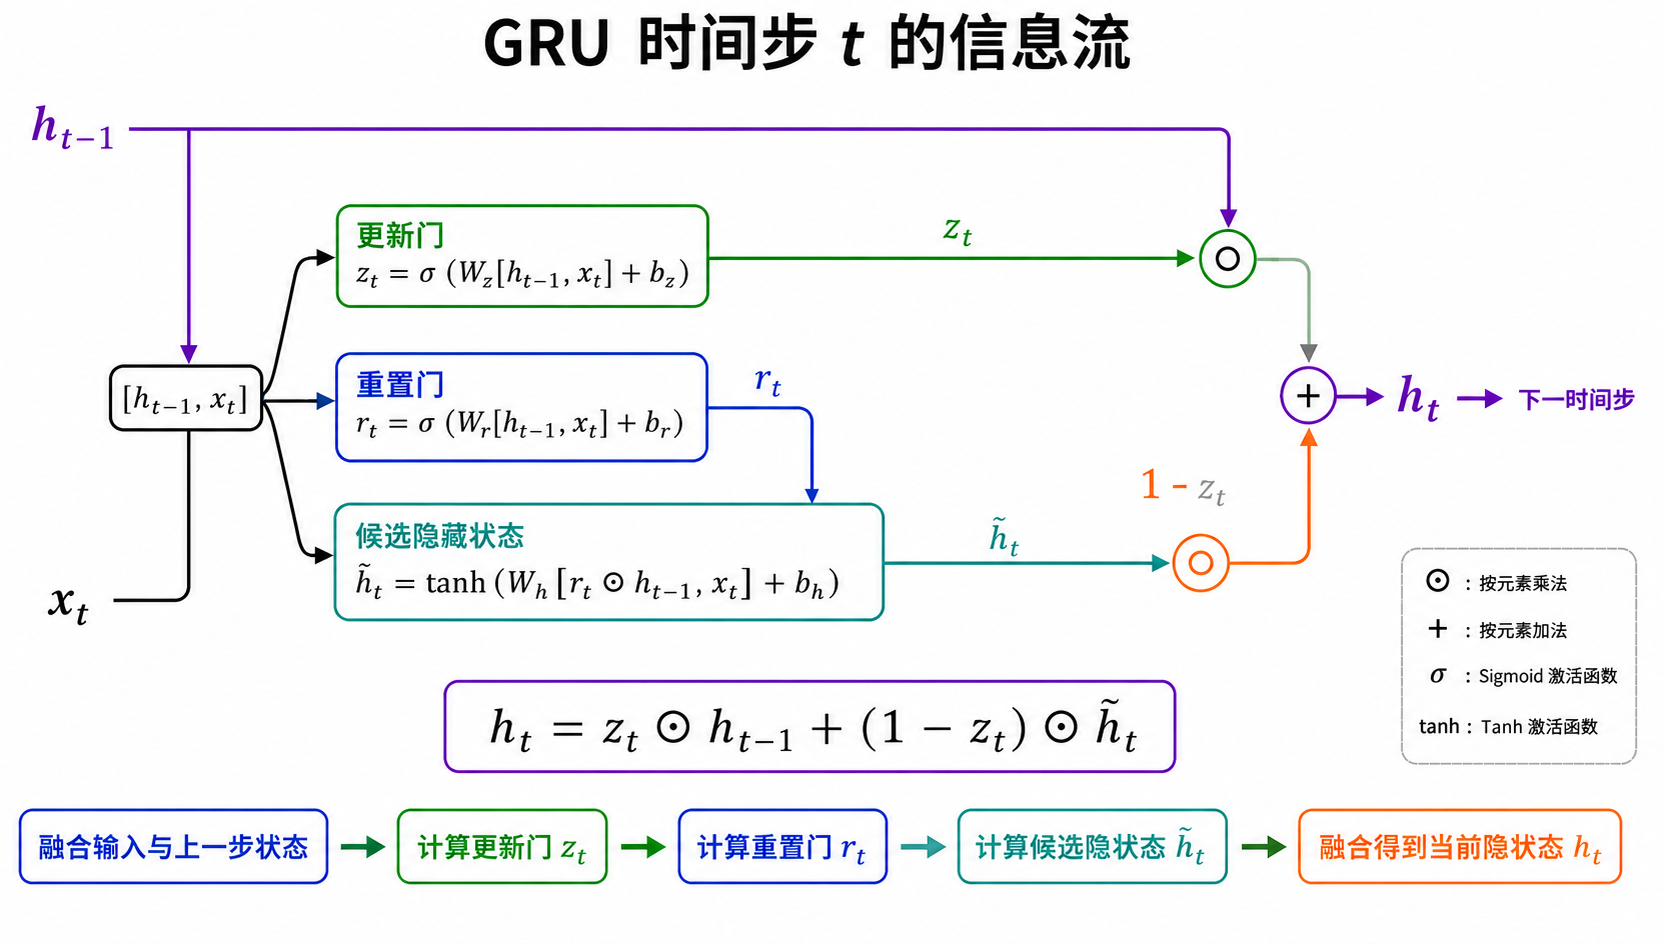
重置门控制计算候选状态时参考多少过去
GRU 先计算重置门
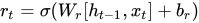
然后用重置门筛选上一步隐藏状态,再结合当前输入生成候选状态
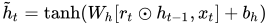
当的某些维度接近 0 时,计算候选状态会较少参考对应的历史信息,更集中地根据当前输入形成新表示;当它接近 1 时,过去状态会更充分地参与候选状态计算。
重置门只影响候选状态如何生成,并不直接决定最终状态丢弃多少历史。最终保留旧状态还是采用新候选,由更新门负责。
更新门在旧状态与候选状态之间插值
更新门的计算方式是
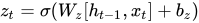
GRU 的当前状态写成
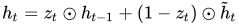
当接近 1 时,GRU 主要保留旧状态;当接近 0 时,则主要采用新候选状态。更新门同时承担了 LSTM 中部分遗忘门与输入门的作用,因为旧状态和新状态的权重被绑定成与 ,两者此消彼长。
不同资料有时会交换与的记号,把定义成新信息的写入比例。两种写法表达的是同一件事,阅读公式时需要先确认更新门究竟控制旧状态还是候选状态。本文沿用 PyTorch 对最终状态更新的记号,让表示旧状态的保留比例。
把 GRU 的一次更新放在一起,就是
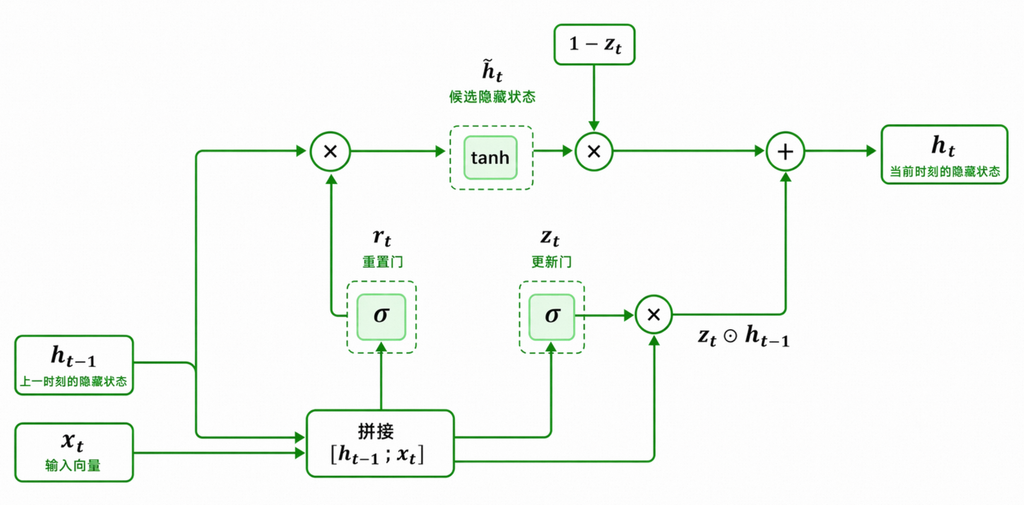
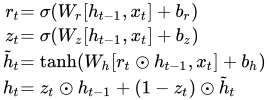
GRU 没有独立的输出门,既承担跨时间步传递信息的任务,也是当前时间步向外提供的状态表示。它对状态的控制没有 LSTM 那样细分,但计算步骤更少、参数量通常也更小。
GRU 通常能用比 LSTM 更少的参数和计算取得接近的效果,因此成为循环网络中常用的轻量化选择。
Highway Network 把门控带到前馈网络
2015 年初受 LSTM 启发诞生的 Highway Network 把门控思路从时间维度带到了深层前馈网络。一个 Highway 层可以写成
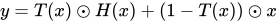
其中 是变换后的新特征,
 是变换门(transform gate),这个形式与 GRU 的状态更新非常接近。网络可以根据当前输入,决定哪些维度采用新变换,哪些维度继续携带原来的特征。门控的保留与更新机制由此从时间上的长链,扩展到了网络层之间的深链。
ResNet 去掉门控,保留直接路径
随后 2015 年底出现的 ResNet 进一步简化了这条思路,它不再为保留路径计算门值,而是用恒等映射作为捷径,只让主路径学习需要补充的残差
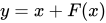
Highway Network 需要学习原信息保留多少,ResNet 则默认原信息完整通过。这样一来,已有表示始终拥有一条不经过复杂变换的直接路径,主路径只需要在此基础上学习必要的修正。
从 LSTM、GRU 到 Highway Network,再到 ResNet,背后的优化思路非常类似,深层或长链计算不应该强迫信息每一步都被完整重写,给已有表示保留一条更直接的路径,可以同时改善信息传递与梯度传播。
Highway Network 的提出者 Srivastava 等人在后续论文中明确指出,ResNet 可以被视为 Highway Network 的一种特例或简化版本。两者都是为了解决深层网络训练困难(梯度消失/退化)的问题,核心思想都是让信息能够无损地穿过多个层。
LSTM 和 GRU 仍然受限于循环结构
LSTM 与 GRU 显著改善了普通 RNN 的长期依赖问题,但它们仍然属于循环神经网络。门控改变了状态如何更新,没有改变时间步之间的依赖关系
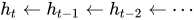
第步必须等第 步完成,单条序列内部无法同时计算所有位置。GPU 擅长大规模并行矩阵运算,但循环结构只能沿时间逐步推进;序列越长,前向与反向传播所需的串行步骤就越多,这成为 LSTM 和 GRU 在大规模文本训练中的主要效率瓶颈。
门控也没有彻底消除长距离传播,LSTM 细胞状态的梯度仍会连续乘上遗忘门,GRU 的旧状态路径也会连续受到更新门影响。如果有效距离达到数百甚至数千个 token,长期信息仍可能逐渐衰减。
固定维度状态带来的信息瓶颈同样还在,LSTM 把长期状态与当前输出分开,GRU 提供了更灵活的状态更新,却仍要把截至当前位置的历史压缩进固定维度向量。序列不断增长时,模型仍然需要决定保留什么、舍弃什么,无法随时直接访问任意一个早期 token 的原始表示。
与其要求一个定长状态把所有历史一路携带到当前位置,不如让模型在需要时直接查看相关位置。这就是后续演进的 Attention 机制。Attention 缩短了信息访问路径,Transformer 的 Self Attention 又进一步去掉时间步递推,让同一层中的所有 token 可以并行计算。
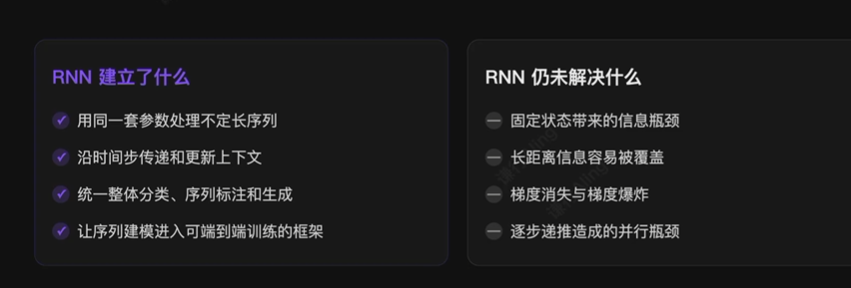
总结:RNN、LSTM 与 GRU 对比
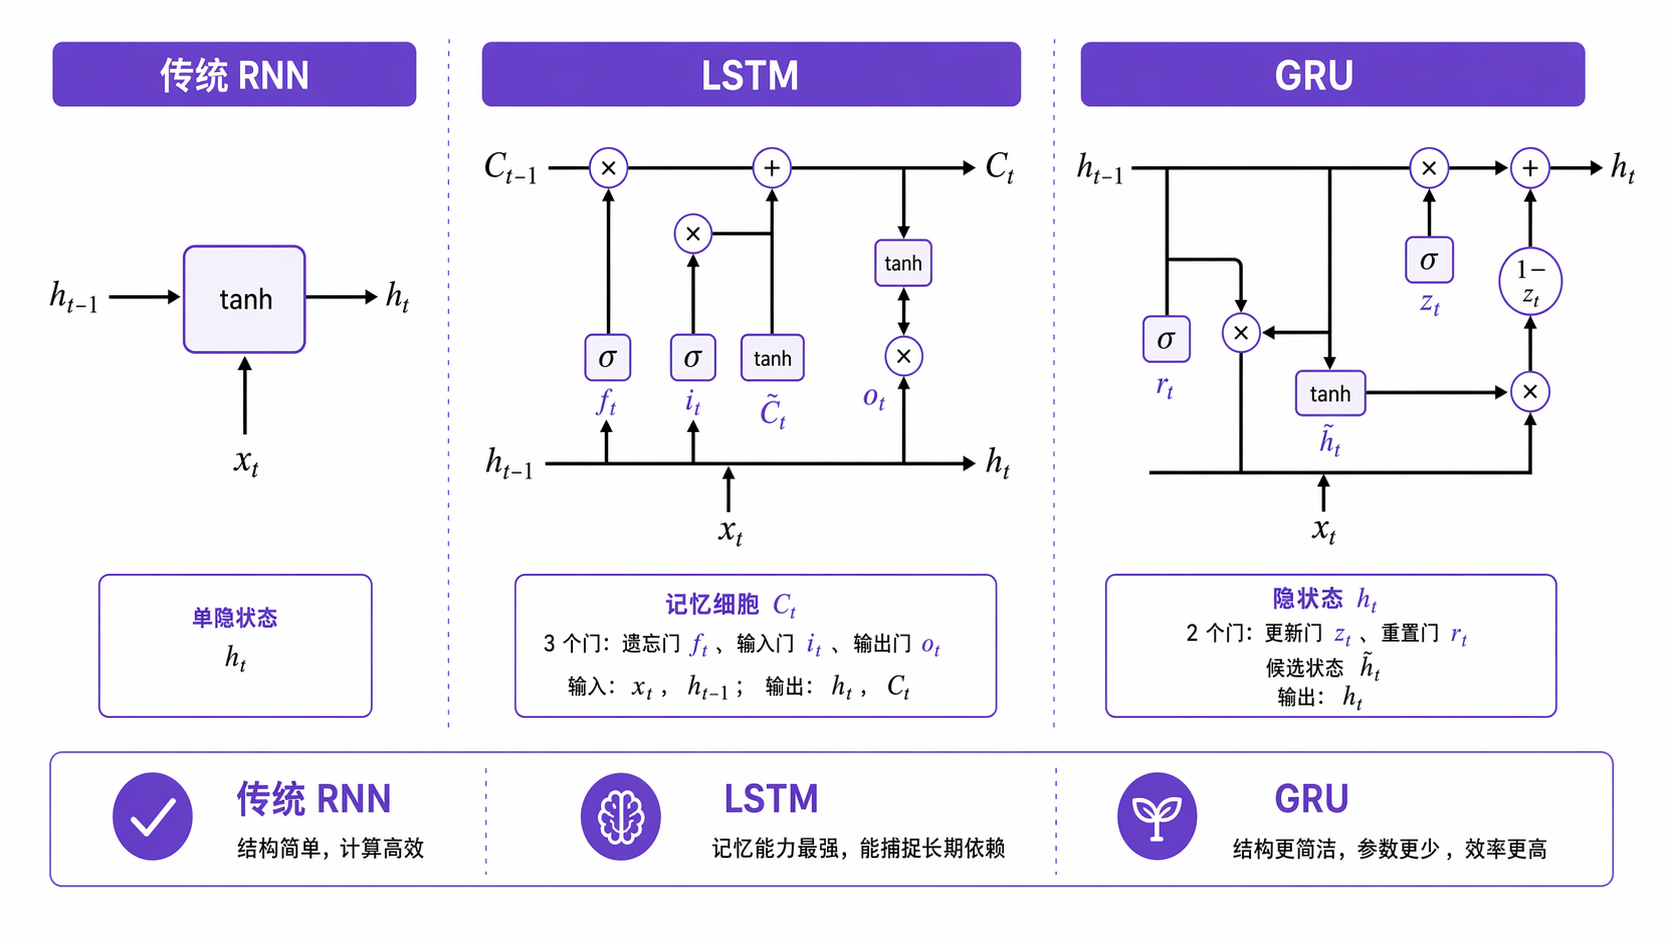
RNN 证明了神经网络可以通过共享参数与隐藏状态处理变长序列,即使 Transformer 已经很成熟的今天,两者在语音、传感器、时间序列、边缘设备和低延迟流式任务中,仍然具有明确优势。它们的局限主要出现在需要超长上下文、大规模并行训练和任意位置直接交互的场景